 Haibin's blog
 Research
MLSys25 talk from lidong: the next horizon of systems
MLSys25 talk from lidong: the next horizon of systems
Listening to Tianyin Xu: Notes and Reflections
Reflections on Tianyin Xu’s podcast interview: PhD applications, systems research, advising, AI, formal methods, and building a meaningful research life.
Large Scale Machine Learning
机器学习优化公式学习笔记 主题:Lipschitz 连续性、Lipschitz smoothness、quadratic upper bound(descent lemma)、strong convexity、PL inequality,以及梯度下降的一步下降、contraction、linear/geometric convergence 和 condition number。 记号约定:目标函数为 F: R^d -> R ,梯度为…
听Tianyin Xu老师的播客
我第一次知道Tianyin老师,是我在翻各个学校导师主页时看到了他的主页。Tianyin的主页非常有意思,让我发现原来兴趣和学术可以这么硬核地展现。刚好我妈在旁边,笑着说感觉这个老师的风格和我很相似。可能是因为都看起来喜欢技术?后来25年我在芝加哥的时候去了两次UIUC,但是老师刚好都不在,后来才知道Tianyin那时在MSRA。结果26年我来了MSRA,然后老师又走了哈哈哈。 我刷到月球大叔的播客里对Tianyin的采访时,就一次性…
阿里云百炼 Qwen 请求 Trace 分析
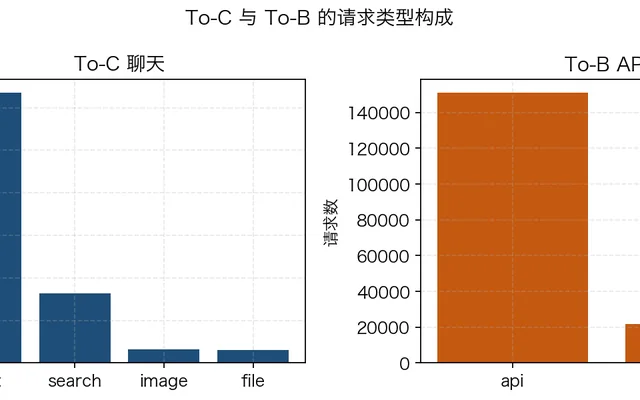
数据来自阿里云百炼上的 Qwen 推理集群,Apache 2.0 开源。 文中统计均由全量扫描四条 JSONL 得到(每条数据约 2 小时)。 这份开源请求数据集的仓库存有2小时 C 端聊天、B 端 API、长思维链、代码助手四类流量。 这是什么数据? Qwen-Bailian Anonymous Dataset 每条记录有到达时间、输入/输出长度、会话父子关系、请求类型,以及按 16 token 一块 哈希后的 hash_ids…
A Static Home for a Living Archive
The first note in a versioned, portable home for research and life records.
Research Has Its Own Backpropagation
A small theory of feedback, experimentation, and growing into a research question.
Caseboard:像侦探一样做科研
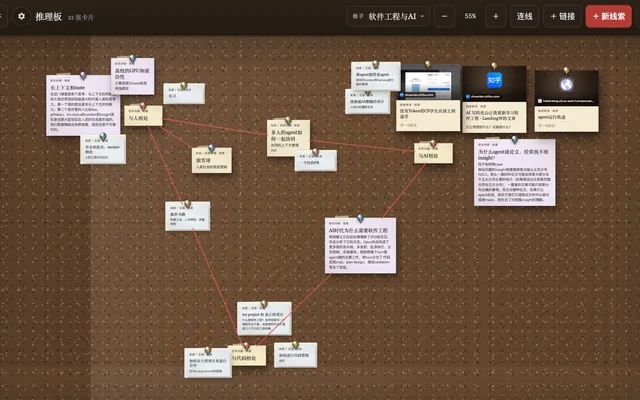
我一开始想写的是一篇博客,记录我在AI coding和research里对软件工程新的想法。比如我们曾经经历了“如何让新agent接手学习老agent的代码”,“让人类拯救被agent毁坏的代码工程”这些故事。但是我发现,我的这些观察都非常的零散,当我开始用一个结构化的语言去讲述他们的时候,我总是不知道怎么衔接和叙述 后来有一天我开始用意识流或者魔幻现实的视角去描述,发现效果非常有趣。大概故事的内容是四年前AI还只是一只猫娘,现在猫娘…
最后的观星人 读书笔记
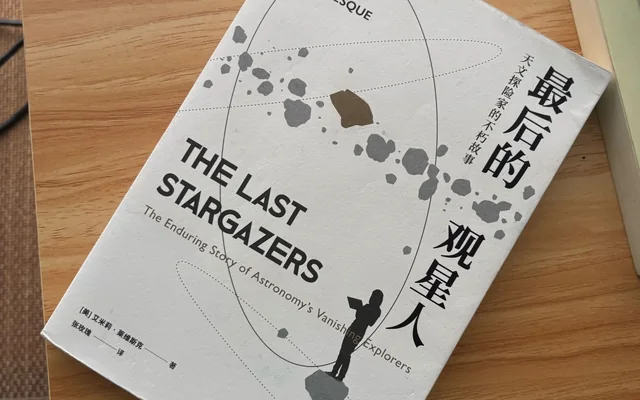
这些天我看了一本书《最后的观星人》。这本书的作者emily是一位天文学教授,她分享了她在读天文学phd时各种观星故事。天文学的phd主要工作是做数据分析以及到全世界各个望远镜里观测,emily分享了去天文台观测的各种搞笑亦或艰难的故事,比如设备坏了要当临时机械工程师,在通宵熬夜看数据时怎么跟疲倦和3000米高原的寒冷斗争,睡觉时与头部大的狼蛛共眠,操控望远镜时造成了几千万美元的损失等等。 总的来说,这本书无时无刻写出了作者对天文学的热…
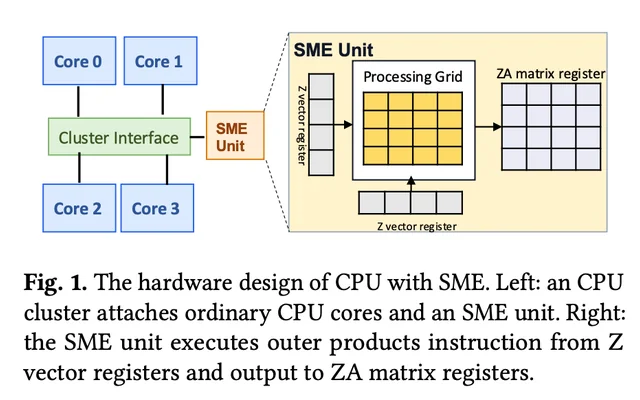
SMEPilot: Characterizing and Optimizing LLM Inference with Scalable Matrix Extensions
来自IPADS的文章。这篇文章把ARM里的矩阵加速器SME用在CPU LLM Serving上。SME是ARM提出的一个加速装置,功能类似Intel的AMX加速器(AMX类似GPU里的TensorCore) Modern CPUs increasingly integrate matrix extensions, such as Arm Scalable Matrix Extension (SME) ARM的SME跟Intel里AMX…
WIP 《悉达多》
悉达多确曾识得许多德高望重的婆罗门,尤其是他的父亲,那纯净的、博学的、最值得敬仰的父亲。他的父亲确实令人钦佩:其举止沉稳而高贵,其生活洁净如水,言语中蕴含智慧,额际间闪耀着细腻而高尚的思绪。然而,即便是这般通达之人,是否真正得享极乐?是否真已安于内心的和平?他是否也仍只是个探寻者,仍是一个灵魂干渴之人?他是否仍需一次次来到圣泉之前,如饥似渴地吮饮?仍需依靠祭祀、经典,以及婆罗门的辩论之言以解心中之困?为何这位无瑕之人,日日仍须洗净罪孽…
采访稿子 2025.12
采访于2025年11月28日,此时我还没确定任何未来的offer,agent的时代刚刚拉开序幕。以下内容主要记录个人经历和思考,不代表所有计算机学生的最佳路径。内容根据录音有修改。 学姐: 同学你好!今天的访谈是我们课题组研究的一部分,主题是南科大学生的成长、课程作息和专业选择。我们希望了解你们在南科大的真实感受和体验。 BIN: 学姐好,我是BIN,是树德书院计算机科学与技术专业的大四学生。目前我的升学意向是读博士,主要申请计算机系…
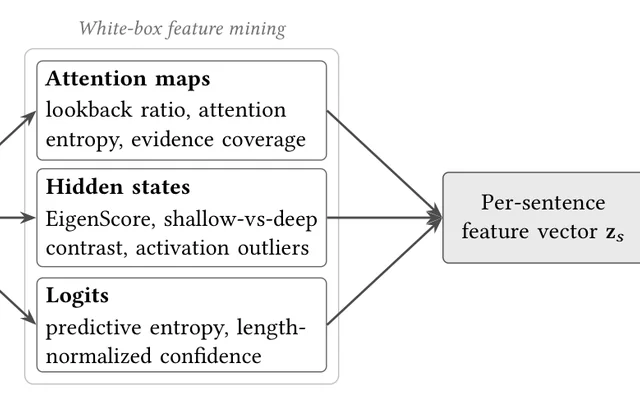
A Survey for White-Box Feature Mining in LLMs' Hallucination Detection
White-Box Feature Mining for Hallucination Detection in Large Language Models This post is adapted from my CS306 Data Mining course report. The original PDF version is available here: data_mining_personal.pdf . Abstract…
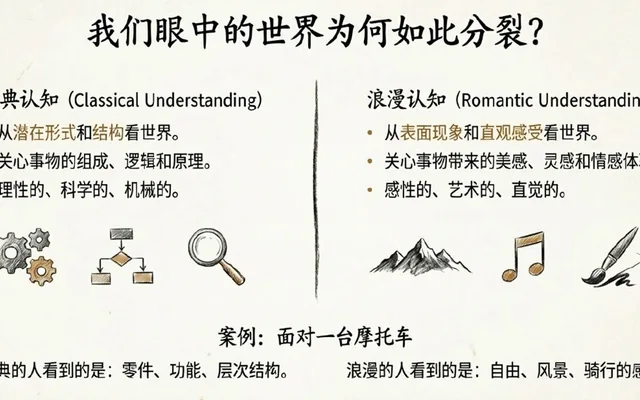
WIP: 禅与摩托车的维修艺术
最近我感觉自己精神虚无。打游戏从之前的调味剂变成生活后,我开始迷失自我。在AI、同辈压力等等事情交杂中,我需要重新慢下来,深度思考一段时间。 《禅与摩托车》:内心宁静与心流 - 好好笑先生的文章 - 知乎 https://zhuanlan.zhihu.com/p/19816425
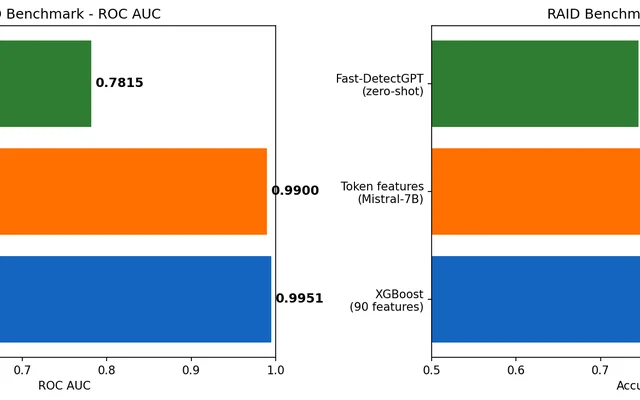
Learning how to detect AI-generated text: use RAID benchmarks as an example
RAID Benchmark: Multi-Generator Detection & Adversarial Robustness Analysis 数据挖掘方面的小项目。最核心的idea是,AI生成的文本短小,且喜欢概括核心思想。检测的主要办法是再用AI跑,看困惑度。 final report: https://github.com/HaibinLai/HC3/blob/main/reports/data_mining_proj%…
图个数问题与burnside引理
问题 一个图G(V,E),如果有8个顶点,一共有多少个这样的图? 这个问题涉及到一个有趣的burnside引理,今天我们借这个问题来学习下这个图论引理。 不考虑同构情况 在这种情况下,我们假设每个顶点和边都有id,也就是他们是独一无二的。 如果默认是 无向简单图 ,也就是: 顶点已经固定为 8 个; 没有自环; 两个顶点之间最多一条边; 边没有方向。 那么 8 个顶点之间最多有 \binom{8}{2}=\frac{8\times 7…
构建之法 - 学习笔记
因为是自己边读边记录的,会有些乱 章节 1 概论 讨论了什么是软件工程,小项目跟公司级别的大项目的区别。各种工程化和管理化的方法。 纸飞机、莱特兄弟的飞机、波音747客机的飞机例子举的非常好,让人对大型软件项目有了更深的理解。 这些天我在调制SGLang的时候,也遇到了类似的问题。LLM Serving已经进入到了一个非常复杂的问题境界,如同当年Oracle和MS Server一样复杂,每个公司都需要特例化部署。而软件的复杂性让整个系…
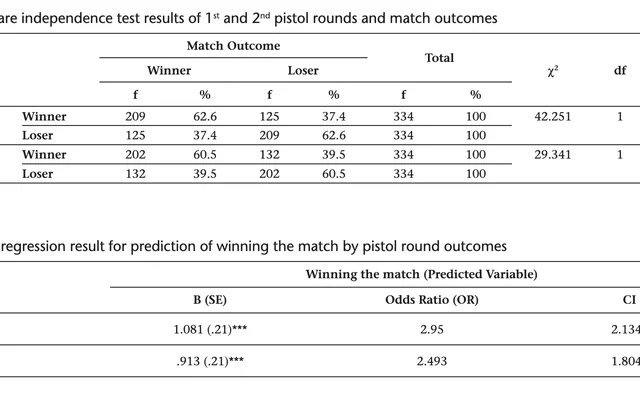
拿下手枪局和首杀对赢得CS比赛有正面影响
文章链接: https://pdfs.semanticscholar.org/3518/8ef0f4bbd7b1209b186ee943d7868832fc7c.pdf 文章标题:Effect of Pistol Round and First Kill on Match Outcome in the Counter-Strike: Global Offensive Major Esports Championships 这篇文章分析…
LEGO: Supporting LLM-enhanced Games with One Gaming GPU
LEGO: Supporting LLM-enhanced Games with One Gaming GPU paper: https://ieeexplore.ieee.org/document/11408477 HPCA2026 (CCF-A) Repo: https://github.com/sjtu-epcc/LEGO Professor: https://mivenhan.github.io/ An algorithm-s…
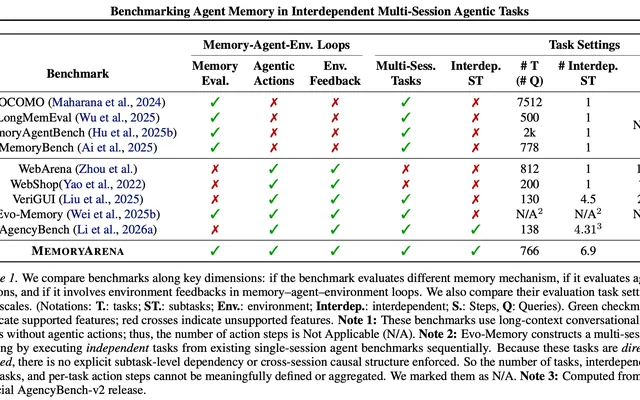
ICML26 Memarena Agent Memory Benchmark
一句话总结:这篇文章揭示了当前 LLM 智能体在处理长期、复杂交互任务时记忆能力的不足,并提供了一个更具挑战性的评估平台来推动该领域的进步 已有benchmark的特点 Large language model (LLM) agents have two complementary core capabilities: the ability to memorize task-relevant knowledge over time…
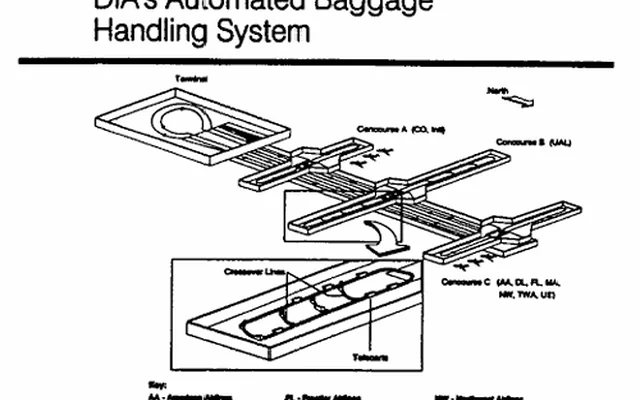
Airport 95: Automated Baggage System?
Paper Link https://dl.acm.org/doi/pdf/10.1145/227531.227544 一篇1996年的老文章。作为课程学习阅读。 这篇文章《Airport 95: Automated Baggage System?》由 A. John Swartz 撰写,主要分析了丹佛国际机场(DIA)自动行李处理系统的失败案例。文章以该项目为研究对象,探讨了大型软件/系统工程中常见的管理问题,并呼吁软件工程界系统性…
OS与硬件的交互:TLB
我: 我已经知道了 OS 里的物理地址和虚拟地址。那难道每次我进行内存访问,都要进行一次转换吗? GPT: 是的,从概念上说,每次内存访问都需要把虚拟地址翻译成物理地址。但这不是每次都由操作系统慢慢查表完成,而主要由硬件完成。CPU 里有一个叫 TLB 的缓存,它保存最近用过的地址翻译结果。如果 TLB 命中,虚拟地址可以很快转换成物理地址;如果 TLB miss,硬件才会去查 page table。 我: 这里,TLB 是硬件在做和…
从零开始造一颗 RISC-V CPU(六):微架构验证体系与 IPC 性能评估
从零开始造一颗 RISC-V CPU(六):微架构验证体系与 IPC 性能评估报告 系列博客第 6 篇(最终篇) —— 在现代 CPU 设计中,验证(Verification)往往占据了流片前 70% 的工作量。本文将全面解析我们如何通过 Python 构建指令集模拟器(ISS)、约束随机验证(CRV)以及端到端的状态机快照比对,验证这套复杂的双发乱序引擎,并给出最终的微架构 IPC 性能跑分。 1. 硅片上的混沌:为什么 CPU 验…
从零开始造一颗 RISC-V CPU(五):乱序执行的来龙去脉与微架构实现
从零开始造一颗 RISC-V CPU(五):乱序执行的来龙去脉与微架构实现 系列博客第 5 篇 —— 深入探讨乱序执行(Out-of-Order Execution)的底层硬件机制。本文将从体系结构历史出发,讲解 Tomasulo 算法的演进,并结合完整的微架构全景图(Mermaid 框图)与核心 Verilog 源码,解析我们在 1000 多行代码内构建的这套乱序执行引擎。 1. 乱序执行的来龙去脉:突破性能的“柏林墙” 在早期顺序…
从零开始造一颗 RISC-V CPU(四):Cache 微架构演进与组相联设计
从零开始造一颗 RISC-V CPU(四):Cache 微架构演进与组相联设计深度解析 系列博客第 4 篇 —— 深入探讨存储器层级(Memory Hierarchy)的底层硬件机制。本文将从早期的“存储墙”问题出发,讲解从直接映射(Direct Mapped)到 2路组相联(2-Way Set-Associative)的架构演进,并结合完整的微架构数据通路(Mermaid 框图)与 Verilog 源码,极为细致地剖析这套 L1 C…
从零开始造一颗 RISC-V CPU(三):TAGE分支预测微架构
从零开始造一颗 RISC-V CPU(三):分支预测微架构 — 从 Bimodal 到 TAGE 引擎的硬核解析 系列博客第 3 篇 —— 深入探讨影响深级流水线性能的核心命题:分支预测(Branch Prediction)。本文将通过微架构层面的演进逻辑,讲解从基础的 Bimodal 到目前工业界最先进的 TAGE(TAgged GEometric History Length)预测器的算法本质,并结合微架构数据通路(Mermaid…
从零开始造一颗 RISC-V CPU(二):顺序双发射(In-Order Dual-Issue)
从零开始造一颗 RISC-V CPU(二):顺序双发射(In-Order Dual-Issue)基线架构与冒险黑洞 系列博客第 2 篇 —— 这是一个非常有意思的工程伏笔:为什么我们最终走向了“乱序执行(OoO)”?本文将解剖我们的基线版本(main 分支)—— 顺序双发射(In-Order Dual-Issue)架构。我们将看看在这套初代架构中,为了保证两条指令同时无碰撞地在深浅管线中平行飞奔,前端译码器(ID)必须设置多少道保守而…
从零开始造一颗 RISC-V CPU(一):项目总览与流水线基础
从零开始造一颗 RISC-V CPU(一):项目总览与流水线基础 系列博客第 1 篇 —— 介绍整个项目的动机、架构全貌、8 级流水线设计以及关键的 hazard 处理。 项目地址: https://github.com/HaibinLai/simple-CPU/tree/main/docs 为什么要自己造 CPU? 每年的计算机组成原理课,都有一个调bug到想死的大作业: 用 Verilog 实现一颗 RISC-V CPU 。今天我…
没有人类了
人之所以为人,是由许多部分组合而成。要成为一个真正的自己,需要的条件会多到让人吓一跳。别于他人的面容、属于自己的声音、睡醒时注视的那双手、童年的回忆、对未来的猜想,还不止这些,还有我的电子脑所触及的咨询海洋,是这所有的一切造就了我,让我意识到自我。但同时,也将我拘束在自我当中。——《攻壳机动队》 我们认为,LLM将取代人类。 人类的复杂度似乎还是超乎了我们于AI的想象。我们认为AI将取代人类,因为一部分工作不需要复杂的模型,只要简单的…
Computer Arch 102
项目 从计算机课堂的5级流水线进一步进阶,制作更强大的CPU。 github: https://github.com/HaibinLai/simple-CPU.git 使用指令集:RISC-V 多发射(Superscalar) Superscalar(超标量)是指 CPU 在一个时钟周期里,不再只发射(issue)一条指令,而是同时发射多条彼此独立的指令到不同执行单元。例如一个现代 CPU 可能同时执行整数加法、浮点乘法、load/s…
MINEDRAFT: A Framework for Batch Parallel Speculative Decoding
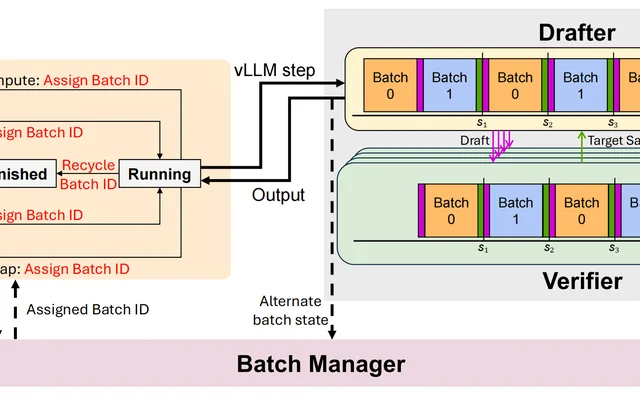
MINEDRAFT: A Framework for Batch Parallel Speculative Decoding 把推测解码打成mini batch,随后在drafter和verifier上分批处理。 在vllm上修改,工程量可观。不错的尝试和idea。 Architecture overview of MINEDRAFT. (Left) The Scheduler manages request life-cycles…
pre-PhD: thinking & planning
来MSRA后,与很多人进行了观点交流和碰撞,真是开拓眼界了。信息密度大,可是任务紧凑,没能每一个idea都细细分析,在这里只能把他们大杂烩。如果有冲突或者重合,纯属个人臆想。 我目前最想去寻找的答案,就是未来5年的phd要做什么。时代的变动非常激烈,在AI的冲击下,传统的system以及HPC的研究方法、方向乃至思路都有可能发生翻天覆地的变革。 System 研究要追上Agent 步伐 古法编程一直是我们System&HPC人“引以为…
S.H.I.T 中国青年虚无主义体验的形成机制与生命意义重建路径研究
paper link: https://shitjournal.org/preprints/7bce9b92-88ef-4f58-ad9b-e84850799939 文章探讨了为什么很多中国青年(初中生、高中生以及大学生)陷入迷茫与虚无主义 1. 为什么会形成虚无主义 文章章节1、2节讨论了这一问题。 作者认为,大部分中国青年最初生长在封闭环境(如学校、家庭)。其环境的封闭性体现在:对人生目标这一“目标函数”的单一性,如“好好学习就会…
(WIP) 梁漱溟 中国文化要义
认识老中国,建设新中国 梁在书的前言中介绍了为什么写这本书:为中国问题所困挠,希望从文化中找到解答。 本书一名《中国民族之前途》。内容分上下两部:上半部为认识中国 问题之部,下半部为解决中国问题之部――因要解决一个问题,必须 先认识此一问题。中国问题盖从近百年世界大交通,西洋人的势力和 西洋文化蔓延到东方来,乃发生的。要认识中国问题,即必得明白中 国社会在近百年所引起之变化及其内外形势。而明白当初未曾变的老 中国社会,又为明白其变化之…
Maxime Gonthier - GPU data locality and out-of-core task scheduling
title brief introduction: time line videos links (personal only): https://www.bilibili.com/video/BV13KAkzcECz/?vd_source=4871cfa497362c1a843af2ecff18ab7f basic question \ 先测一个简单版本,如2min,然后知道计算时间,接着进行5h的跑
Agent + Website
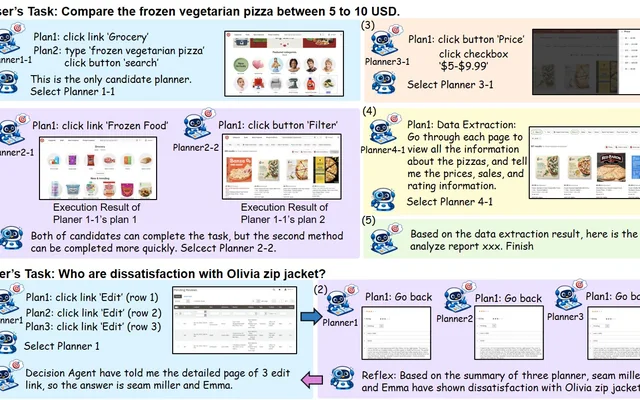
WebTactix Semantic Tree-Guided Parallel Multi-Agent Planning for Web Task — 基于语义树引导的并行多代理规划框架。 将任务变成搜索树 Agent并行的BFS去决策完成最佳搜索 任务预处理 将用户请求转换成明确的约束集合,这样可以清晰地检测任务是否完成。 简化观察 (AxTree) 把原始的网页可访问性树转换为简化文本版的 AxTree。 去除重复元素。对重复结构…
SCA26 Trip to Japan
可能是一篇比较流水账的游记,提前磕个头说个抱歉( PS: 我插入了一些歌曲在行程中,欢迎点击来听听 :) 时隔九年,我再次踏上关西的土地。 飞机降落在关西国际机场,摆渡车玻璃厚实,却显出深圳未曾有的清凉,混合着机场里特有的淡淡的、干燥的清洁剂味。阳光在金属扶手上跳跃,窗外运行李的小车有条不紊地卸货,更远处是静默的塔台与深蓝的大海。 九年一瞬,这些情景仿佛昨日。很多坐标没有变,但坐标系里的人与故事天翻地覆。我去了老景点,也有新景点。我见…
ISCA25 Neoscope: How Resilient Is My SoC to Workload Churn?
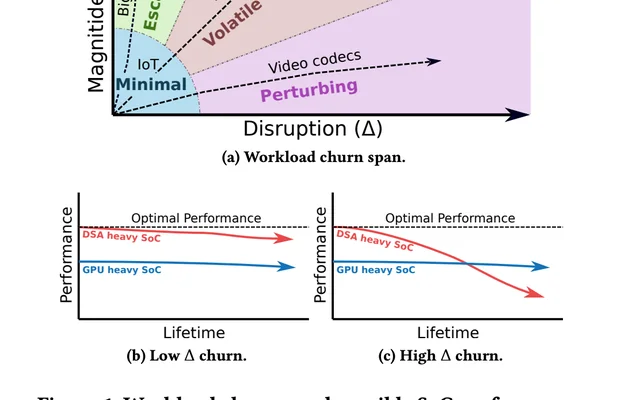
未来的硬件怎么应对不断演变的软件? https://dl.acm.org/doi/pdf/10.1145/3695053.3731014 这篇文章是 ISCA 2025 的论文 《Neoscope: How Resilient Is My SoC to Workload Churn?》 ,核心在回答一个非常系统/架构导向的问题: 当软件和工作负载不断演进(churn)时,一个 SoC 设计在整个生命周期内还能保持多“好”? 其建模并定…
ATC25 Colocating ML Inference and Training with Fast GPU Memory Handover
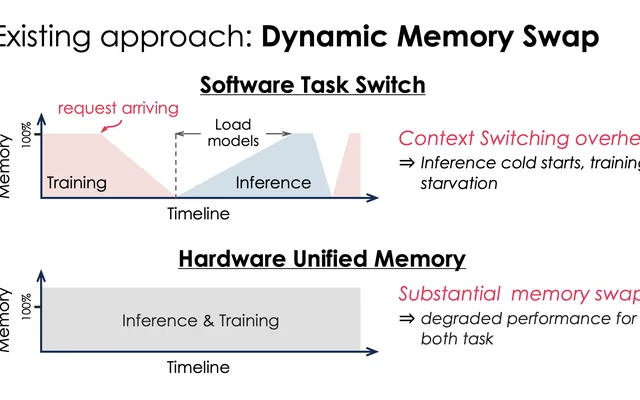
今天yf来分享一篇来自IPADS的ATC25文章。 Colocating ML Inference and Training with Fast GPU Memory Handover 简短点评:依旧IPADS特有的大工程,TVM+vLLM+NCCL+Pytorch 开组会大家一起问了很多问题。 https://ipads.se.sjtu.edu.cn/_media/publications/sirius-atc25.pdf 这篇文章…
STOC81 I/O Complexity: The Red-Blue Pebble Game
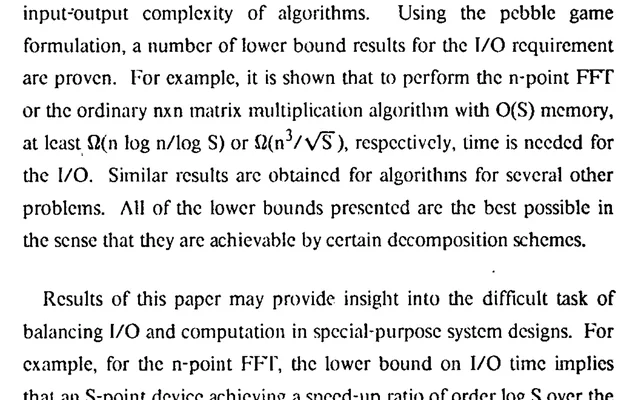
STOC81 I/O Complexity: The Red-Blue Pebble Game 这是一篇理论计算机科学文章,但是描述了一个非常有趣的问题:就像时间复杂度一样,我们能不能做一个I/O复杂度,衡量一个程序最少要进行多少次I/O? 文章链接: https://www.eecs.harvard.edu/~htk/publication/1981-stoc-hong-kung.pdf Compute不贵,I/O才贵 随着现代的C…
In-depth analysis: RetroInfer: A Vector-Storage Approach for Scalable Long-Context LLM Inference
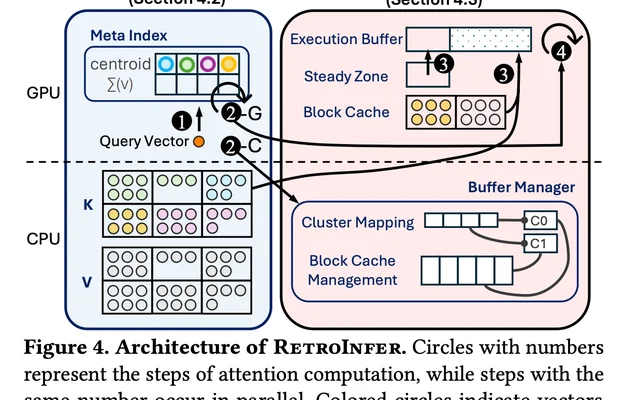
之前用LLM看文章,后来发现同样20分钟时间,学到的东西其实不如自己认真读读+关键问题请教。 KVCache可以用上 RAG 技术吗? 这篇文章的idea是:能不能 "build KVCache as a Vector Storage System." 在长上下文情况中,KVCache经常超出显存,那么我们只能把多余的KVCache存进CPU内存里。而这样就很慢(CPU-GPU传输慢且数据量大)。一种方法是利用LLM的“稀疏”,我们发…
Task-based Parallelism models and their techniques Overivew
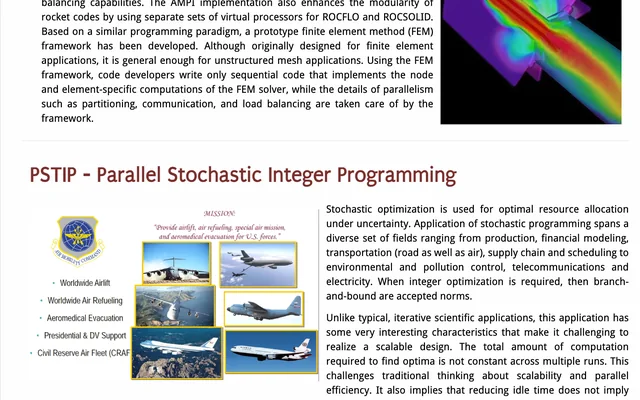
So far there are many task programming models. Charm++ Website: https://charmplusplus.org/applications/ Github: https://github.com/charmplusplus/charm Tutorial: https://charm.readthedocs.io/en/latest/index.html From UIU…
Distributed and Cloud Computing Assignment 4
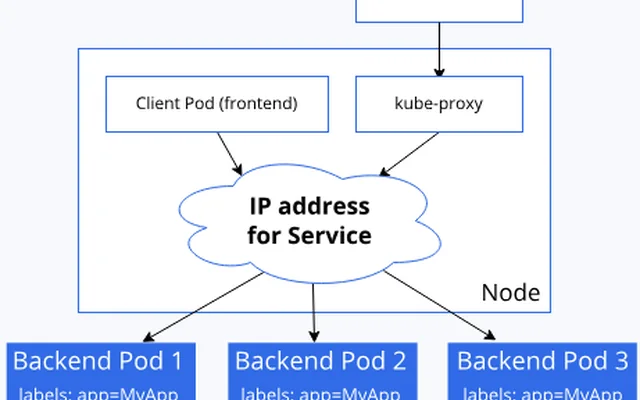
Feedback Feedback to Learner 12/30/25 3:55 PM 82+5=87 (extra: 0) > Summary: As we demonstrated in the lab, you should pre-assign labels and taints to cluster nodes using Kind config YAML. Other parts are all perfect! >…
America Against America
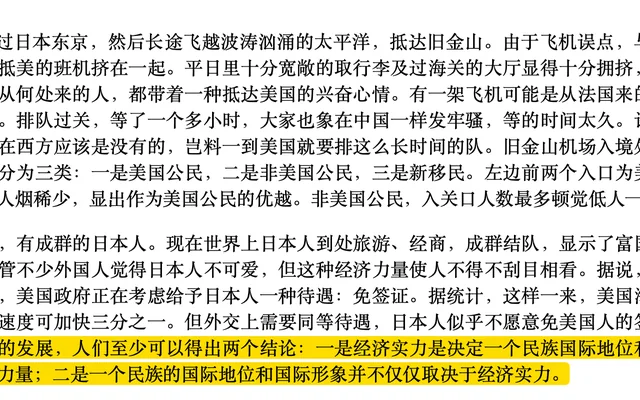
美国反对美国 第一次系统性思考美国,始于高中时读林达夫妇的《历史深处的忧虑》。后来又看了托克维尔的《论美国的民主》。再然后到今天 Hu'ning Wang 的《美国反对美国》。几个来自不同时间、不同国籍、不同立场的作者在他们的书里,对美国政治、经济、文化进行了多方面的观察。于我而言,我也从纪录片到真正踏上这块陌生的土地过上半年生活。再重新思考书里提到的一切,有了很多新的体验。 同样是游历半年,王考察了更多人和地区,比起计算机技术问题…
Learn Compilers in 6 hours
半个学期在申请,半个学期在忙paper,基本上没怎么动过这个课程。但是课程整体考试是不难的。 高效“备考” 周一下午16:30的考试,我从周一凌晨3点开始学,早上9点结束。睡5小时下午2点起床吃早餐+洗澡,然后考试,69/100。 反正大四了,过了就行,分数就图一乐。 这个人讲的最好,古希腊掌管编译器的神明。只讲题目,全程干货。 【【武汉大学】编译原理混子速成——面向期末试卷复习:全集】 https://www.bilibili.co…
Distributed Systems and Cloud Computing: Review 1
This is the self-review pack of Distributed Systems and Cloud Computing. We have lesson 1-5. Lesson 1 Presentation – Effective communication of information rather than of data – Code and number conversion – Transmission…
DnCC3: Introduction to Spark
In this assignment, we need to use Spark to analyze the Parking dataset. Preparing Install pysark and java pip install pyspark sudo apt-get update sudo apt-get install openjdk-17-jdk export JAVA_HOME=/usr/lib/jvm/java-1…
DnCC Assignment 1: Parallel Matrix Multiplication
https://github.com/HaibinLai/Distributed-and-Cloud-Computing.git 【分布与云计算 - DnCC 复习】 https://www.bilibili.com/video/BV1eovaBTEW9/?share_source=copy_web&vd_source=72eac555730ba7e7a64f9fa1d7f2b2d4 Setup Compile We can use…
A Simple Merch Store Backend: Distributed and Cloud Computing Assignment 2
Scores 95+10=105 (extra: 5) Summary: The impl is nice in general, and the report is awesome! Yes, this is an assignment where you should follow certain instructions and submit certain stuff, but just like what you menti…
Rowhammer 行锤攻击
Intro Learn from Prof. Onur Mutlu: https://www.youtube.com/live/mEt-hhLHBG4?si=TsmRN04wcqbcQs0e Rowhammer(行锤攻击) 是一种硬件层面的安全漏洞,主要发生在 DRAM 内存 中。攻击者不需要破解软件或操作系统,只要反复高速访问(“hammer”)同一行或相邻行内存,就有可能导致相邻内存行的比特翻转(0→1 或 1→0),从而破坏数据…
You and your research | Richard W. Hamming
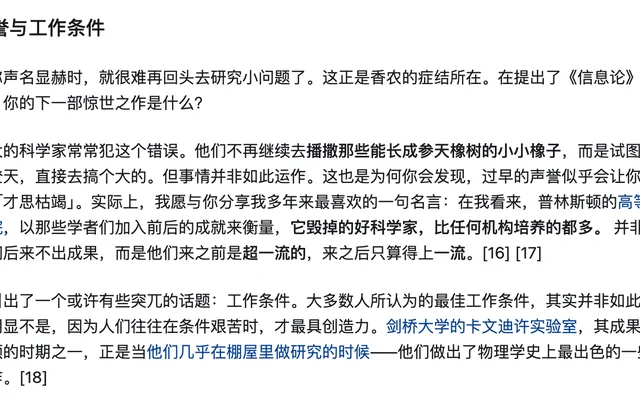
你和你的研究 https://gwern.net/doc/science/1986-hamming Great work is something else than mere brains. Brains are measured in various ways. In mathematics, theoretical physics, astrophysics, typically brains correlates to a g…
MoonshotAI: Sharing for VibeCoding Examples and Debug Techniques
Vibe coding Meetup北京场|VibeCoding案例和Debug技巧 https://www.douyin.com/video/7543627062267923747 这个视频记录了月之暗面Kimi对vibe coding的分享。 软件工程: 没有银弹 -> AI? 现在AI可以跑几十分钟,处理大量的数据+代码 windsurf 收购 Claude Code | Cursor | Windsurf | Copilot…
The Old Man and the Sea 劳而不获
《老人与海》发生在上世纪的古巴,那个离我和我的世界很远的地方。一个渔夫钓上一条大鱼,随后与风暴中的鲨鱼搏斗,最终鱼肉都被它们啃食干净,只带回了鱼骨。 高中的我很不解。一个拼尽全力却无功而返的故事,听起来没什么意义。我不解老人到底在想什么,为何要去进行一场毫无意义的搏斗。简直和堂吉柯德一样,执拗而又带有一点愚笨和悲哀。 老人与海。有人说这是他见过最不对等的两个事物放在同一个标题里。老人有什么能力跟大海搏斗呢,搏斗后的结局,排去彩排赌徒般…
怎么用AI写2000行的大作业
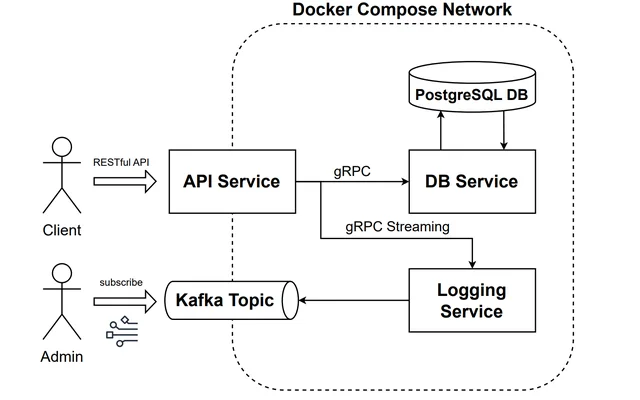
2026年3月16日更新: 看看这篇文章: 从 FAST26 SPECFS 看新时代 infra 开发者工作范式 - SPtuan的文章 - 知乎 https://zhuanlan.zhihu.com/p/2015537008425055371 人类已经丛底层编码走向编排者角色。我们需要编排agent去建立完善的控制体系。 最近分布式课程有一个作业。作业内容是要写一个商城的后端。商城消费者通过网页API访问/消费商品,后端商品数据库有…
我在CPU修PMU:Can We Trust Profiling Results?
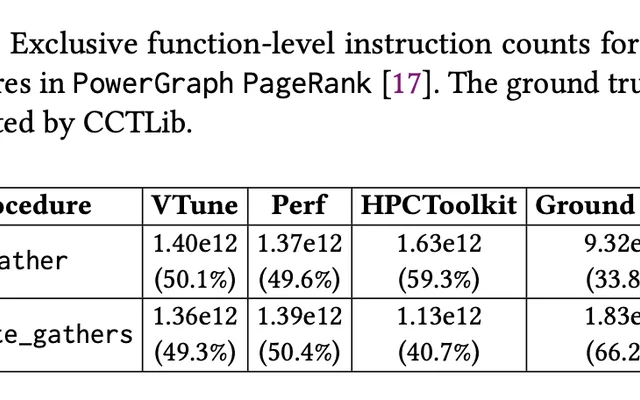
Can We Trust Profiling Results? Understanding and Fixing the Inaccuracy in Modern Profilers https://par.nsf.gov/servlets/purl/10122098 在上次阅读完博客 # Where Do Interrupts Happen? 后(我的中文解析: https://www.haibinlaiblog.top/index…
AI Compiler Group Meeting
109 pages PPT,from TVM to Mirage. Introducing AI Compiler 101. Cost 90 minutes. PPT and videos: https://drive.google.com/drive/folders/1eKcHZKMpix31EcioiNCf16AzLIHkvGyy?usp=sharing
现在的学生缺乏对大型工程动刀子的能力
我的接触的同学和我的观察力都比较有限。但是在这些天做研究、跟朋友聊科研,问大家迷茫/卡在哪,都感受到这一点。 现在的学生缺乏对大型工程动刀子的能力。 XX github proj 跑不起来。编译/安装阶段超过10条命令就束手无策。超过30页的文档找不到对应的命令。甚至连问GPT都问不明白 ...... 以前总有学生吐槽说,实验室里学长不愿意带学生。但是没有基础实在是太难带了,简直是拖累节奏,并且心很累。虽然我也经常几小时干出蠢事,但是…
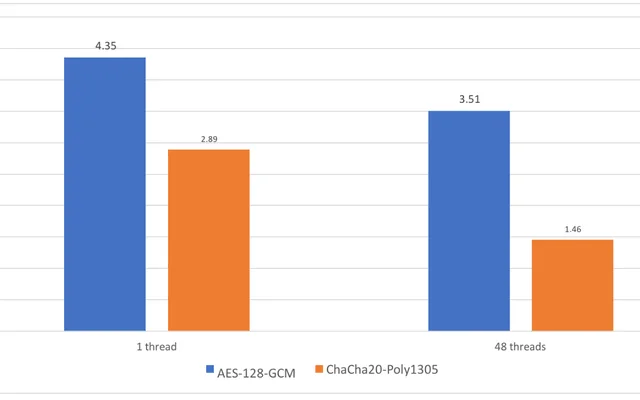
神文解析:AVX 是怎么让你的CPU频率更慢的?
GB! 本文依旧是超神作者 Travis Downs https://x.com/trav_downs 的技术博客解读。文章链接 Gathering Intel on Intel AVX-512 Transitions https://travisdowns.github.io/blog/2020/01/17/avxfreq1.html 本文是在其基础上的分析与解读,若内容涉及侵权,请与我联系,我将立即进行修正或删除。 AVX/AVX…
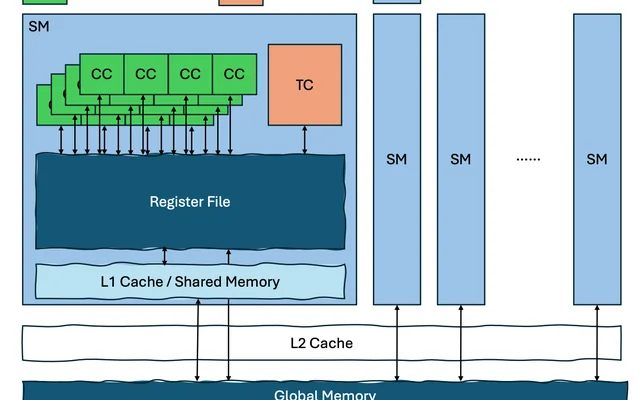
Can Tensor Cores Benefit Memory-Bound Kernels? (NO!)
本文学习自 Can Tensor Cores Benefit Memory-Bound Kernels? (NO!) https://dl.acm.org/doi/pdf/10.1145/3725798.3725803 这篇文章提出了一个有点惊人的观点:Tensorcore在面对 memory bound 的kernel/算子时效果并不是很好!文章用优秀的理论公式分析+实验验证了这点。读懂这篇文章,就能懂Roofline model的…
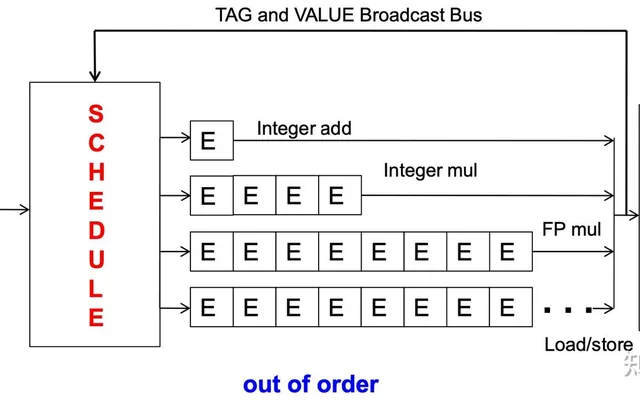
Where do interrupts happen? 中断触发点在OOO处理器中的分布——神文解析
神文解析:Where do interrupts happen? 原文: https://travisdowns.github.io/blog/2019/08/20/interrupts.html 看完标题和第一句话,我就知道今晚这篇文章要让我睡不着了。看懂这篇文章需要一定的体系结构基础,对OoO,中断的机制比较了解。 在中文网站上我似乎没有看到类似的讨论。在考虑后,我决定将本文写为解析。我会将我的解析和信息汇总与原文翻译区分。本文的…
NSDI26: Can we use MLFQ in LLM Serving?
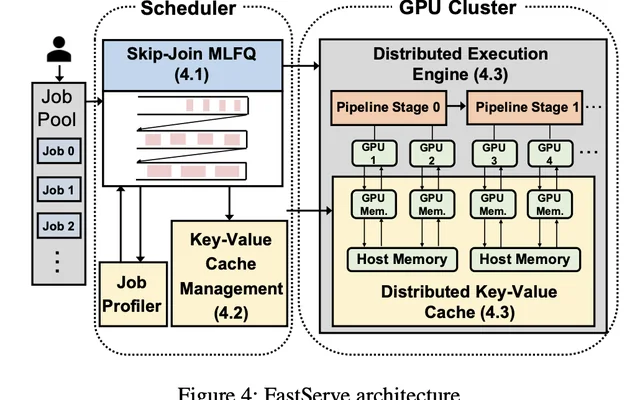
This paper is in arxiv for 2 years. Then it goes into NSDI26. Maybe we can see the difference between versions of 2023 and 2026. Paper link: https://arxiv.org/pdf/2305.05920 Main idea: Can we use MLFQ, a scheduling algo…
Why Greatness Cannot Be Planned
看到一些退休的prof的谷歌学术,做了30年,40多篇文章。仔细一想,人的一生不也就是这些文章和产出。一年一篇工作,不算那些挂名的,似乎也就能发个30来篇,从此之后,就没什么文章了。 5年phd看起来很长,其实好像也就是3-5个关键项目,如果其中有一个改变了世界,已经很不得了了。15年的工作看起来很长,其实也就是那几个项目,改变的机会在哪里? 一万年太久,只争朝夕。是应该一生做一件事, 还是不断改变方向? 车灯只能照亮50米,但你同样…
Distributed System 5: Bayou Algorithm
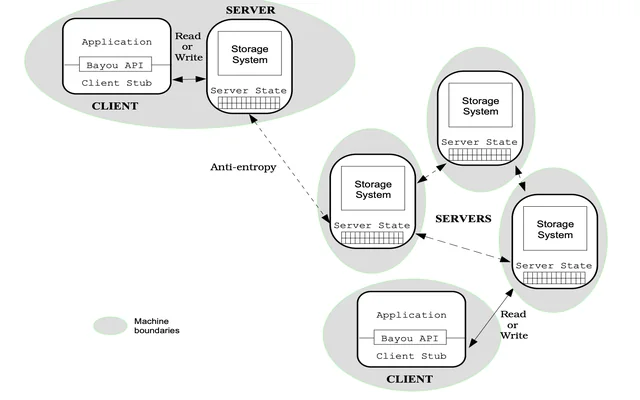
分布式一致性 怎么在弱网情况下保证事件一致性,弱网指的是,只能时不时连接一下。 Bayou [bayou](1995) Bayou是一篇神奇的论文,在1995年这个互联网还没有普及的时代,就开始讨论分布式系统中弱一致性的问题。Bayou考虑的应用场景是移动设备不具备稳定的网络连接,如何保证这些不具备稳定网络连接的设备组成集群,处理读写操作时,用户看到的数据是合理的。Dynamo [dynamo] (2007) Dynamo也是一个弱一…
Distributed System 4: Chandy-Lamport Algorithm
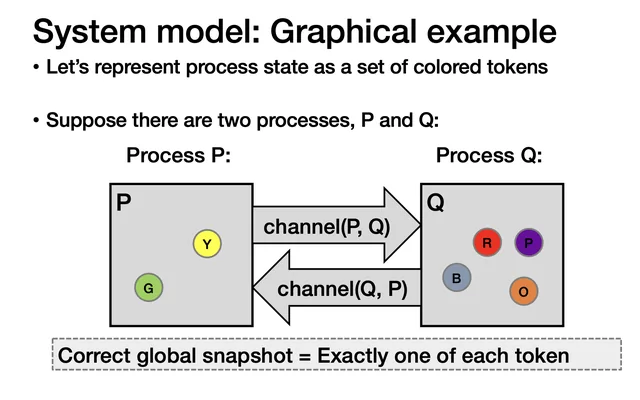
Snapshots: save the data 我们想要捕捉系统在某一时刻 TTT 的 一致全局状态 ,包括: 每个进程的本地状态; 每条通道上的消息状态(即“正在飞”的消息)。 常见应用场景: 检查点恢复(Checkpoint / Rollback Recovery) 检测全局死锁 检测全局不变式(如是否所有账户加和为常数) 调试 / 稳定状态检测(如终止检测) 问题是: 在分布式系统中没有全局时钟,进程之间的消息异步传递,我们无…
Distributed System 3: Vector Clock
Review: Time is important in Distributed, for determine sequence. But we can't find a sync time for everyone. Vector Clock Lamport didn't solve: Solution: use a vector clock 两个向量一样:同一个事件 一个向量小于另一个向量:所有元素都小于等于,但是不能全部等于 并…
GridFTP: SC25 Test of Time Award
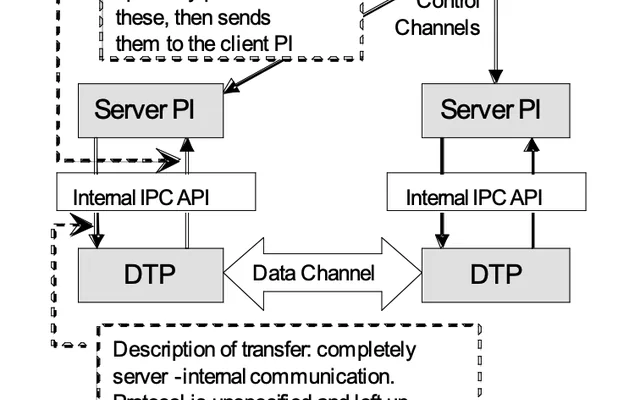
How to move massive data from server to client? How to serve multiple users around the world to use the compute machine? This technology was not invented in cloud computing, but grid computing. And this is the paper pub…
Eurosys24 Orion - GPU Kernel Scheduling for ML Inference
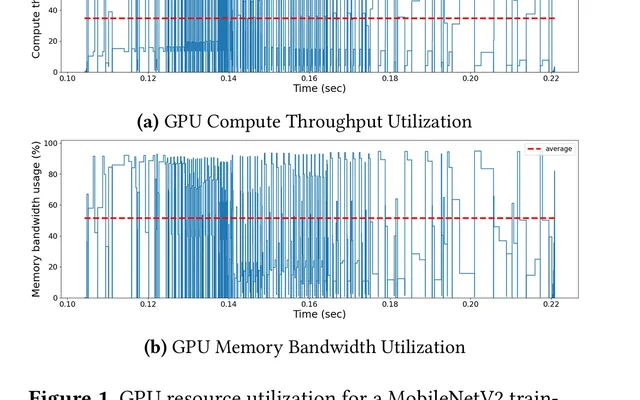
Paper Orion: Interference-aware, Fine-grained GPU Sharing for ML Applications Github eth-easl/orion: An interference-aware scheduler for fine-grained GPU sharing Abstract GPUs are critical for maximizing the throughput-…
FALCON: Pinpointing and Mitigating Stragglers for Large-Scale Hybrid-Parallel Training
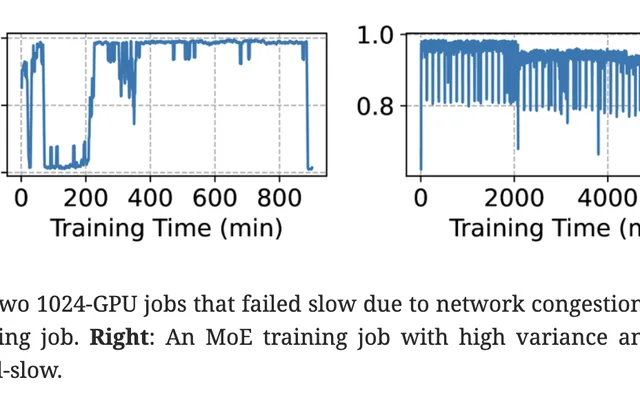
FALCON: Pinpointing and Mitigating Stragglers for Large-Scale Hybrid-Parallel Training Fail-slows, or stragglers, are common but largely unheeded problems in large-scale hybrid-parallel training that spans thousands of…
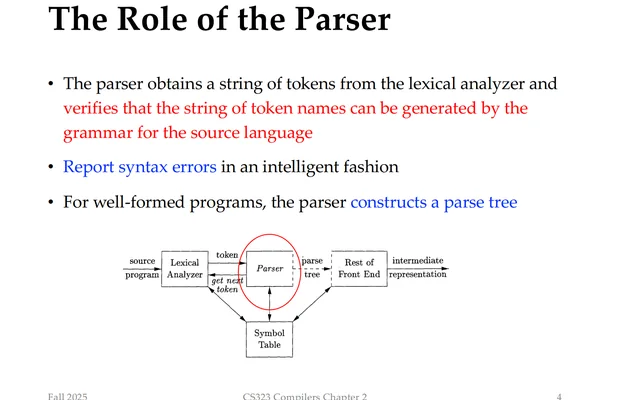
Compiler 4: CFG, Parsing
CFG Terminal: 对应loop,对应if,对应XX Productions: 产生式 Derivation推导 CFG可以推导很多不同的式子 Notations Terminologies 文法的句型 这里我们看到,文法 最左推导 & 最右推导 在编译原理中, 最左推导 和 最右推导 都是从文法的开始符号(Start Symbol)出发,通过不断用产生式替换非终结符,逐步推导出一个句子的过程。区别在于: 每一步选择替换的非终…
Compiler 2: Regrex, Finite Automata
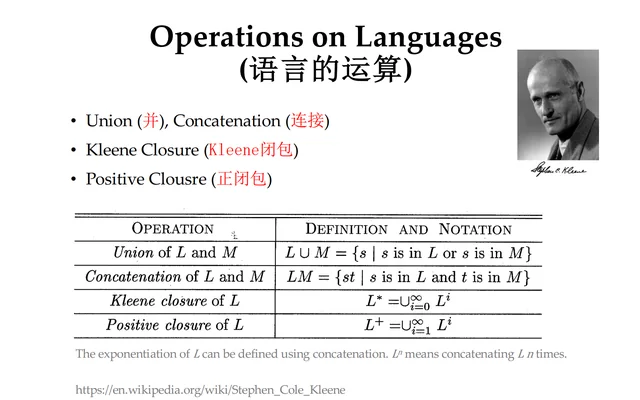
语言运算 Regular Expression 形式语言 For describing Languages / Patterns if, else, ... 形式化定义正则表达式(regular expression, regexp),给出了一系列归纳规则(induction rules) Basic $\epsilon$ is a regexp, $L(\epsilon) = {\epsilon}$ And if a is a sy…
Compiler 3: NFA, DFA, CFG
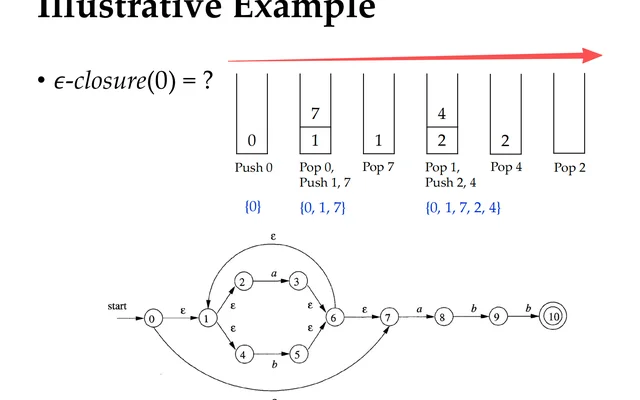
第一章最后一部分+CFG Convert NFA to DFA The algorithm here is to explore the state [1,2,3,4,6,7,8] 是在move[A,a]后能达到的所有状态 ![[Pasted image 20250921142734.png]] 我们用达到闭包的个数,来判定目前的状态 Start State A (We have 0), Accepting States E (We…
Compiler: Intro
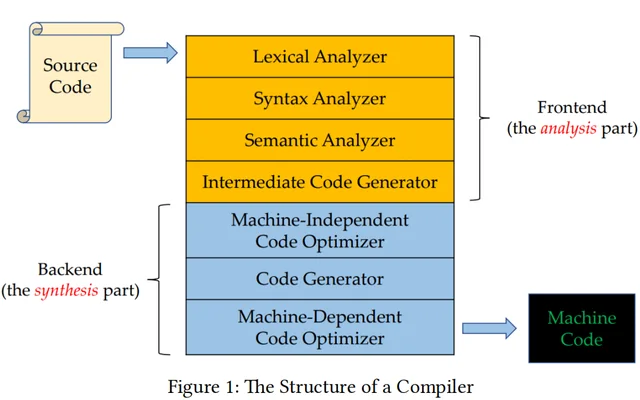
Operations on Languages Languages: accountable for strings Lexer Lexical Analyzer(词法分析器,也叫 Scanner)在编译器中扮演着 前端第一步的角色 。它的主要任务是把源代码(程序员写的字符序列)转化为 Token 序列 ,供后续的语法分析器(Parser)使用。下面我分点介绍它的作用: 1. 输入与输出 输入 :源程序(字符流,如 if (x > 0…
Distributed System 2: Time
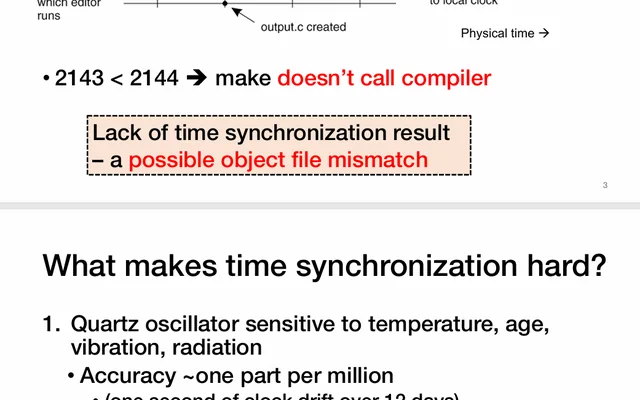
不同的机器需要同步 分布式实时操作系统研究的是 如何在分布式多节点环境中,提供确定性调度、时间同步、实时通信与容错机制,从而保证关键任务的 deadline 被满足 。它既是操作系统的研究热点,也与工业控制、车联网、航空航天等应用紧密相关。 下面的图片是: 分布式系统需要同步 同步非常困难 我们是无法完全同步的,只能尽力同步 网络时间协议: Cristian's algorithm 我们很不幸,是无法给每个设备装GPS的 GPS贵 G…
Distributed System 1: RPC
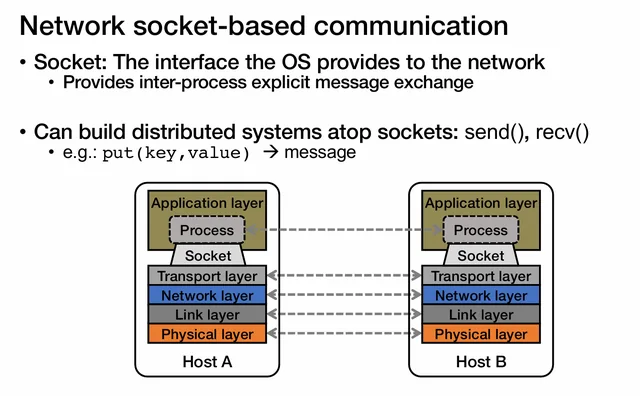
This is a course taught in SUSTech 2025 Fall by Prof. Zhuozhao Li. RPC 为什么要有RPC 因为我们不想socket编程 Goal: Easy-to-program network communication that makes client-server communication transparent RPC 要解决的问题 异构 Failure 性能 For…
ICPP25 Conference story: Day 2
Anne Elster, "Parallel Computing and Geophysical Forecasting" Professor Anne C. Elster Norwegian Univ. of Science and Technology Center for Geophysical Forecasting University of Texas at Austin Geophysical forecasting o…
ICML25 Rocket KV - KV Cache Compression
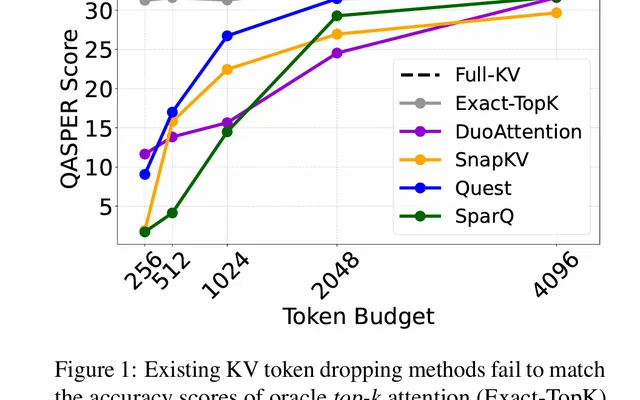
kaixin li github repo: NVlabs/RocketKV: [ICML 2025] RocketKV: Accelerating Long-Context LLM Inference via Two-Stage KV Cache Compression To learn LLM KV Cache Compression October2001/Awesome-KV-Cache-Compression: 📰 Must…
ICPP25 Conference story: Day 1
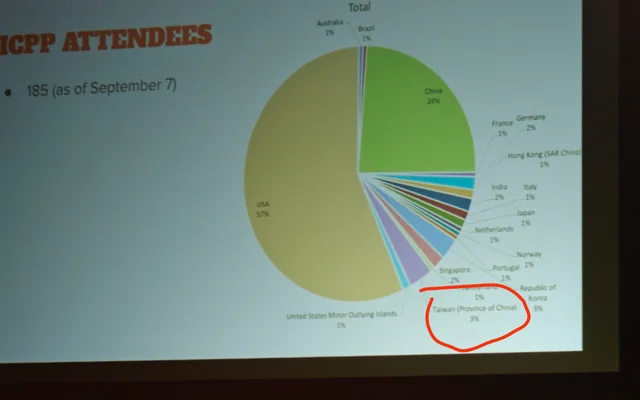
ICPP Conference 会议 Congrats to all accepted papers! Welcome Ceremony 185 Attendee come to the conference! We have 292 submission and 78 of them are accepted! The Chairman's Welcoming! Jack Dongarra, "An Overview of High…
ICPP24 Grace Hopper GPU中的系统内存管理
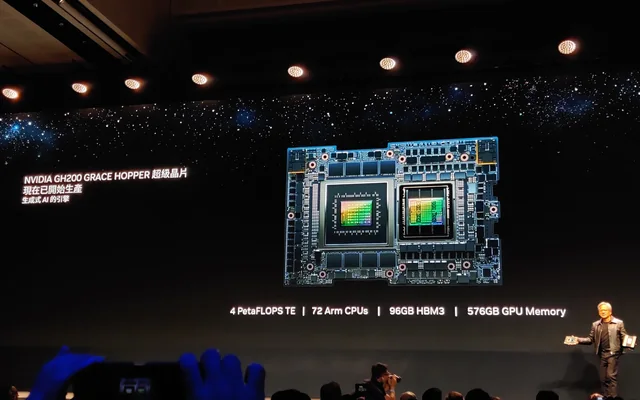
文章链接: Harnessing Integrated CPU-GPU System Memory for HPC: a first look into Grace Hopper NVIDIA Grace Hopper 与 NVLink Fusion 架构对异构并行计算优化的影响 - William的文章 - 知乎 https://zhuanlan.zhihu.com/p/1911971133923754274 Grace Hoppe…
GQA、MHA、MQA、MLA
在苏剑林博客+油管上有更好的介绍。 GQA(Grouped Query Attention,组查询注意力)是注意力机制(Attention)的一种优化变体,主要用于提高大型语言模型(LLM)的计算效率和内存使用效率,同时尽量保持模型性能。它在注意力机制中起到 优化多头注意力(Multi-Head Attention, MHA) 的作用,特别是在 Transformer 模型中。以下我会用简单易懂的语言解释 GQA 的作用和原理,尽量避…
ParslFest 25 会议记录
ParslFest 会议的目标是找到新的idea和设计,以及展示一些用户案例。 Parsl: Parallel Scripting in Python Join our dedicated #parslfest2025 channel on Slack to connect with fellow attendees, ask questions, etc. Not on Parsl Slack yet? Join our space…
NSDI23 Transparent GPU Sharing in Container Clouds for Deep Learning Workloads
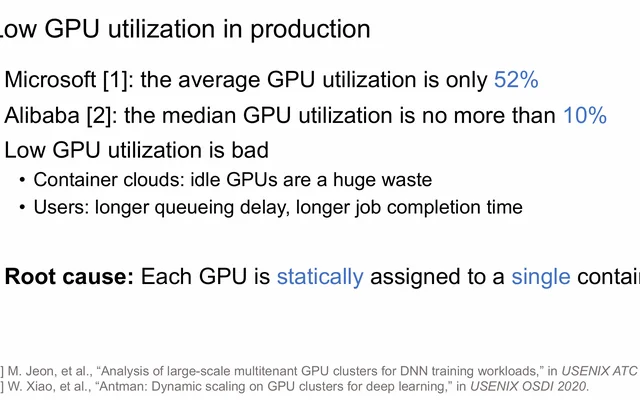
这篇文章介绍了一种名为 TGS (Transparent GPU Sharing) 的系统,旨在在容器云环境中在OS层为深度学习(DL)训练工作负载提供透明的GPU共享,以提高GPU利用率并减少作业完成时间。 links: https://www.usenix.org/conference/nsdi23/presentation/wu 1. 背景与动机 容器云与DL训练 :容器(如Docker)在数据中心中广泛用于资源管理和部署,提供…
ATC24 Power-aware Deep Learning Model Serving with u-Serve
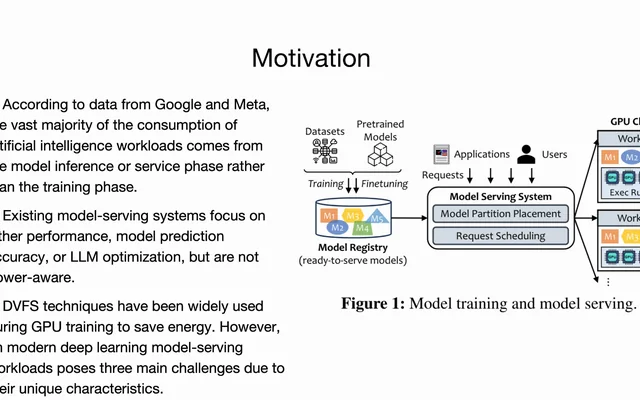
Power-aware Deep Learning Model Serving with u-Serve 这篇文章是发表于2024年 USENIX ATC'24 的论文,标题为《Power-aware Deep Learning Model Serving with μ-Serve》,作者来自伊利诺伊大学厄巴纳-香槟分校和IBM Research。论文聚焦于深度学习(DL)模型服务(即推理)中的功率优化问题,提出一个名为μ-Serve…
OSDI25 PipeThreader
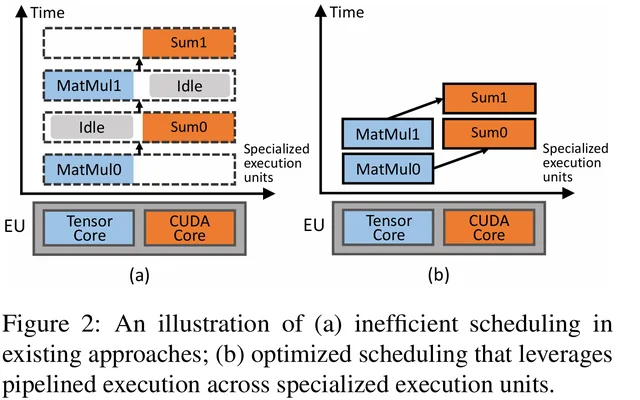
PipeThreader: Software-Defined Pipelining for Efficient DNN Execution AlpaServe 简单总结 背景问题 现在的深度学习模型越来越大,单块 GPU 内存不够用。 多模型在线服务要保证低延迟、高吞吐量,但请求量有时会突然激增,传统方法效率低。 核心想法 模型并行 :把一个模型拆成几部分放到多块 GPU 上。 统计多路复用 :当一个模型暂时不用 GPU,其他模型可以…
硅谷101 清华姚班的经验分享
为什么伟大不能被计划? 【为什么伟大不能被计划?精英教育有多残酷【硅谷101播客】】 https://www.bilibili.com/video/BV1vg92YcEUD/?share_source=copy_web&vd_source=72eac555730ba7e7a64f9fa1d7f2b2d4 清华姚班 创建非常自由 人才不是培养出来的,是在把最好的人聚集起来,给他们时间+空间,足够的自由度,告诉他们世界上有很多的难题,大家…
OSDI25 XSched
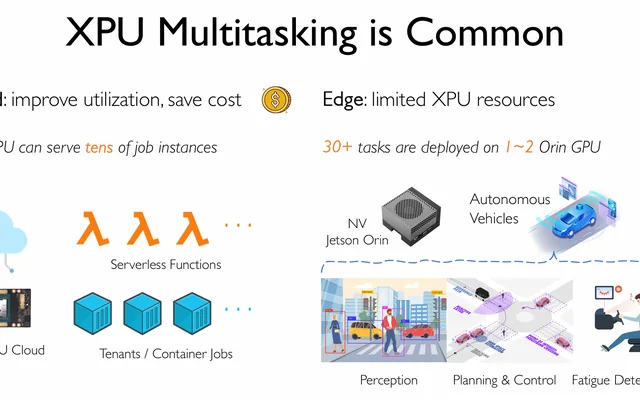
scheduling for XPUs 在XPU上实现抢占式调度 CPU的抢占式调度 抢占式调度(Preemptive Scheduling)是一种 操作系统调度策略 ,核心思想是: 当有更高优先级或更紧急的任务需要运行时,操作系统可以 立即中断当前正在运行的任务 ,把 CPU 资源“抢”过来给那个更高优先级的任务。 XPU XPU: FPGA, NPU, GPU 目前在XPU上做了很多的任务 但是好像没有什么调度 Opps: 抽象成…
CNN 的两个技术: UGC与BatchNorm
Unstructured Group Convolution 1. 普通 Group Convolution Group Convolution(分组卷积) 最早是 AlexNet(2012)用来解决 GPU 显存不足问题的。 做法 :把输入通道分成几个组,每个组只跟自己的卷积核组连接计算。 好处 :减少计算量和参数量(比如输入 64 个通道,分成 4 组,每组只卷 16 个通道,计算量大幅下降)。 结构特征 :分组是规则且固定的,比…
南科大学生系统研讨会 SUSTech Student Sys Seminar
本文大概记录我们第一次南科大系统研讨会的过程和反思。 故事背景 有一天,我想办一个南科大学生的system研究seminar。大概内容是想请几个阶段和领域的学长学姐分享自己的研究,可以是自己的工作,研究的学习历程,研究体会或者单纯的开会经历、做lab的经历。 研讨会的内容可以是不同主题的分享,比如如果有同学能分享"如何阅读CSAPP这本书”“我们的计算机安全课程project"“如何上手MLSys里几个经典框架”"上一段paper做的…
SIGCOMM07 How to read a paper
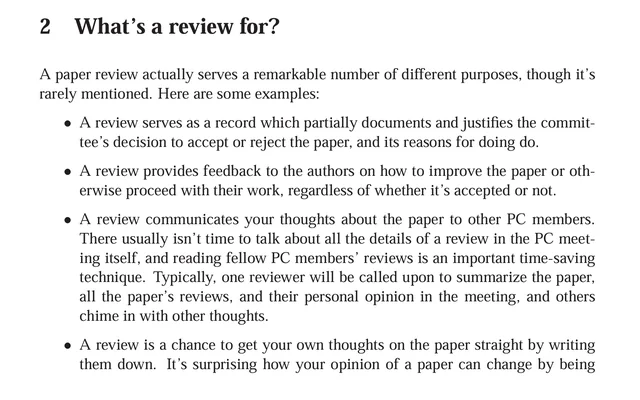
How to read a paper | ACM SIGCOMM Computer Communication Review 没想到真有这种神奇文章,讲怎么读文章。很好,我就用你的方法来读你的文章。 S. Keshav教授写了这篇paper分享了自己多年来阅读论文的经验——即 "three-pass"方法 。它的关键思想是拿到一篇paper不要直接开始从头读到尾,而是分三遍去阅读。每一遍都有明确的目标,是一个 循序渐进 的过程。 第…
25年7月文章 Attention on Hardware
link: SystolicAttention: Fusing FlashAttention within a Single Systolic Array 这篇文章提出了一种针对 Transformer 模型中的 FlashAttention 加速的新架构 FSA( Full Systolic Attention ),旨在解决现有 基于 systolic array 的加速器在执行 FlashAttention 时利用率低 的问题。作…
CIDR22 MMAP = 💩
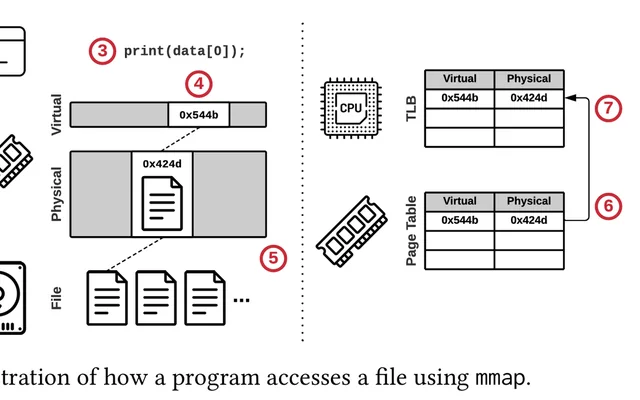
Are You Sure You Want to Use MMAP in Your Database Management System? 内存映射(mmap)文件 I/O 是操作系统提供的一种功能,可将二级存储上的文件内容映射到程序的地址空间中。然后,程序通过指针访问页面,就像文件完全位于内存中一样。只有当程序引用页面时,操作系统才会以透明的方式加载页面,并在内存填满时自动删除页面。 数十年来,mmap 的易用性一直吸引着数据库管理…
FAST25 Mooncake 组会
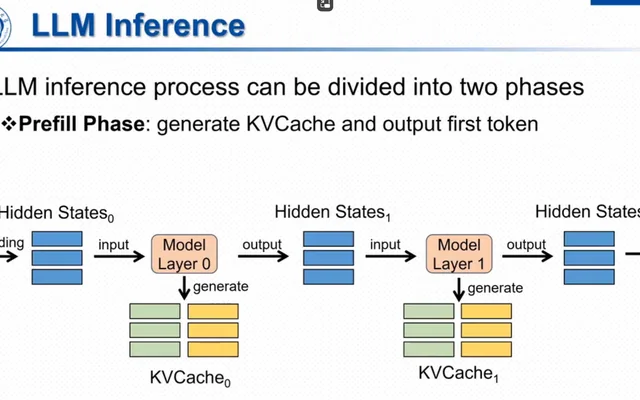
组会录播 【组会FAST25-Mooncake讨论会】 https://www.bilibili.com/video/BV1ZkgUz5E5n/?share_source=copy_web&vd_source=72eac555730ba7e7a64f9fa1d7f2b2d4 学习笔记 【【RG 25 Spring】[FAST'25] Mooncake】 https://www.bilibili.com/video/BV1KmJ8zaE…
MIT6.824 存档:学习笔记
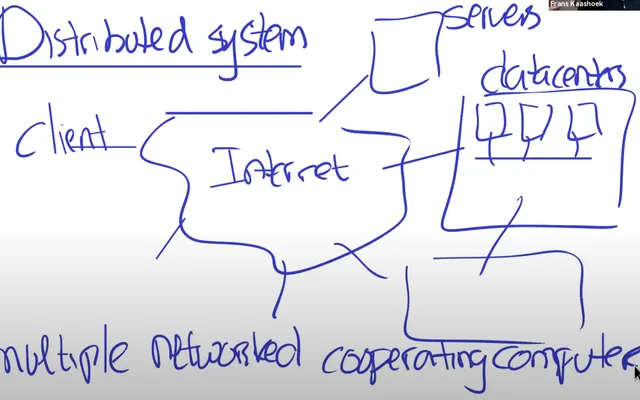
分布式系统组成要素 目标:security fault tolerance parallel computing 人们使用大量的相互协作的计算机驱动力是: 人们需要获得更高的计算性能。可以这么理解这一点,(大量的计算机意味着)大量的并行运算,大量CPU、大量内存、以及大量磁盘在并行的运行。 另一个人们构建分布式系统的原因是,它可以提供容错(tolerate faults)。比如两台计算机运行完全相同的任务,其中一台发生故障,可以切换到…
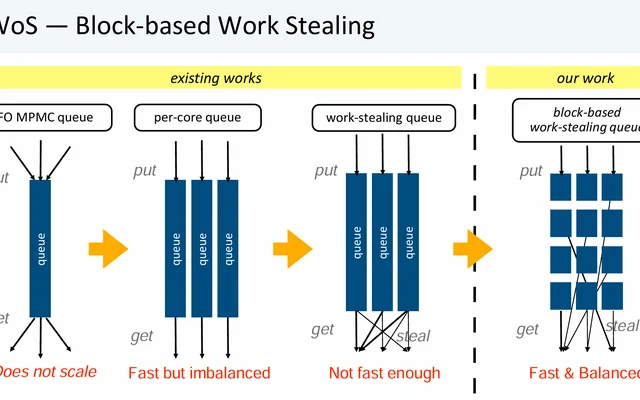
OSDI 23 BWoS 更好的多线程work-stealing技术——分块
一篇有趣的文章,做的是新的多生产者多消费者的队列。 我猜这篇是他们做量化的同学搞的哈哈哈哈哈。 PowerPoint Presentation OSDI 2023 论文评述 Day3-Session11: Verify Your Bits - 知乎 stdexec/include/exec/ detail/ bwos_lifo_queue.hpp at main · NVIDIA/stdexec BWoS Work-Stealing…
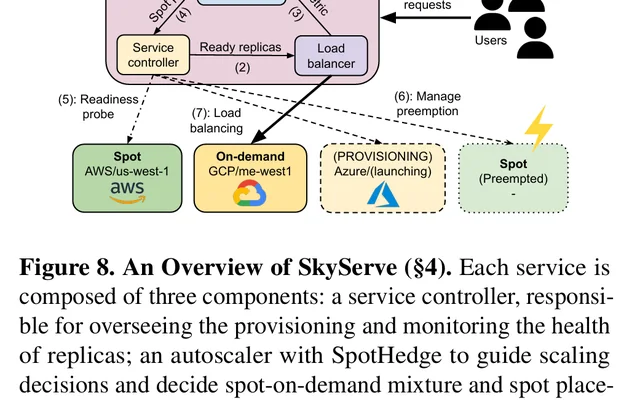
Eurosys 25 Skyserve
来自大名鼎鼎的UCB Sky Computing Lab 他们尝试在云里运行LLM Serve 然后他们考虑的场景是 Spot inference。这个场景类似于云的instance很吃紧,然后会经常的扩增和缩小。在这种 动态场景 下做一个能fault tolerance, load balance的一个推理引擎调度系统。 AI也是微服务 Sky serve 首先把LLM服务当成微服务看待。在这种情况下 In summary, thi…
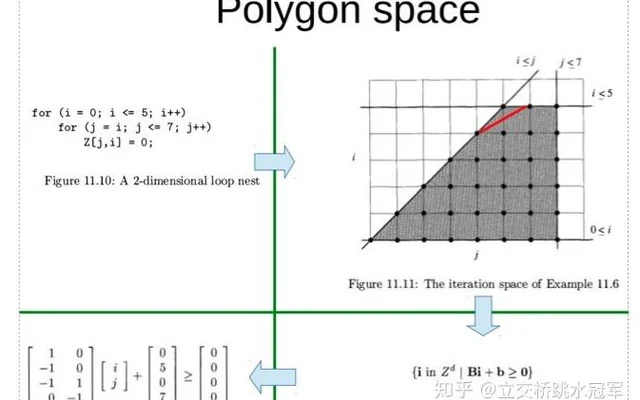
循环优化:多面体优化
多面体模型最关注的(可能也是唯一关注的)就是循环的优化。因此对于多面体模型,它只会把一段段程序当成一堆嵌套循环,至于循环里面的内容他是不大关心的。因此在整个框架中,重要的概念只有4个:Domain,instance,dependency和schedule Statement与Instance: 接触过编译器的同学知道Instruction或者Statement,代表一行代码。而在循环中的代码,每个Stmt的每次执行都是一个Instan…
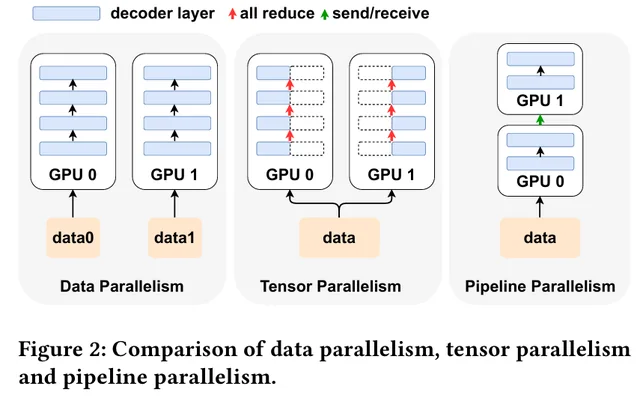
SC25 gLLM
gLLM: Global Balanced Pipeline Parallelism System for Distributed LLM Serving with Token Throttling 几种并行方法 尝试消除泡泡: 目前在LLM推理里有两种不平衡: stage 间不平衡 inter-stage dependency, where a stage cannot begin computation until the pre…
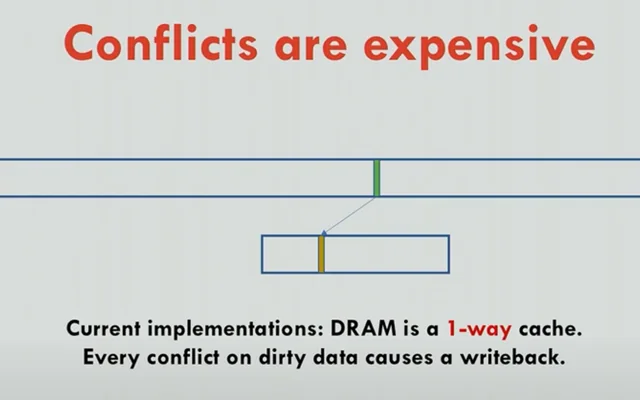
OSDI23 Johnny Cache: the End of DRAM Cache Conflicts (in Tiered Main Memory Systems)
本文解决的是这样的一种情况: 在计算机有CXL、SSD等比DRAM 的存储level更低的存储(文中一般称PMEM)下,现有的“把DRAM当PMEM的Cache”的操作易导致生日冲突,引起Rewrite性能下降。Johnny Cache用了新策略(线性的写)避免了该冲突。 In par ticular, we demonstrate that the poor performance observed in earlier hardw…
复盘:科研里的反向传播
写在做科研的一年 如果一个End2End神经网络的产出是一篇paper,那么复盘是这个网络的反向传播。人们通过复盘,可以调节 “在探索阶段应该跑更多baseline”,“时刻注意我们要做的主题” 等决策想法,从而做到更有效的科研探索。因此,时不时在输出后进行复盘非常重要。 这篇文章在写什么? 出于兴趣,我开始了计算机系统的研究。在简单看了一些书和talk后,我就找了我的好老板,一起 “创业” 找idea干paper了。做研究很不容易…
ASPLOS13 Unikernel: A Special Kernel for Apps in cloud
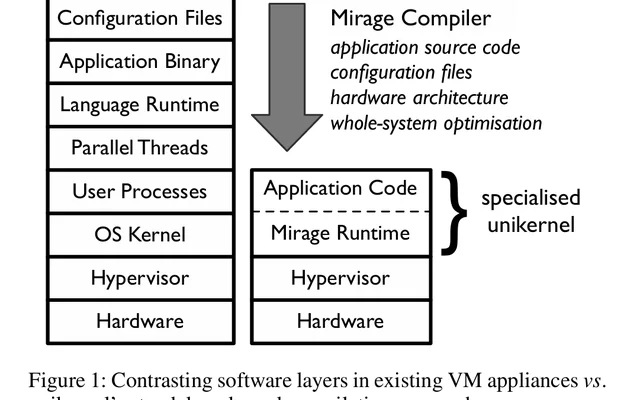
login_oct15_02_kantee.pdf Unikernels - Rethinking Cloud Infrastructure Unikernels: library operating systems for the cloud: ACM SIGARCH Computer Architecture News: Vol 41, No 1 (1 条消息) Unikernel: 从不入门到入门 - 知乎 This passa…
RetroInfer A Vector Storage Approach for Scalable Long-Context LLM Inference
RetroInfer: A Vector Storage Approach for Scalable Long-Context LLM Inference 微软新突破:RetroInfer如何让AI模型处理百万级文本不再"卡顿"? microsoft/RetrievalAttention: Scalable long-context LLM decoding that leverages sparsity—by treating th…
翻译:x86寄存器的历史
EAX x86 Register: Meaning and History [译] 简明 x86 汇编指南(2017) EAX的故事 到底什么是EAX,名字怎么来的。 通常,x86教程不会花太多时间解释设计和命名决策的历史背景。在学习x86汇编时,你通常会被告知类似这样的话:这是EAX,它是一个寄存器,用它就行。 那么,这些字母到底代表什么?E–A–X。 恐怕没有简单的答案!我们得回到1972年…… 8008 :A 在1972 年,经…
huawei 384 节点推理系统赏析
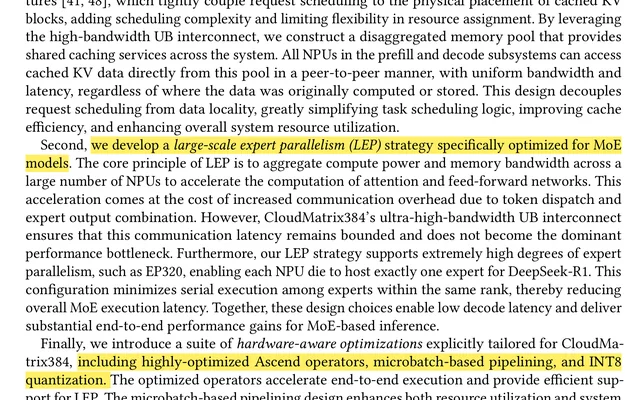
我最好奇的是,这种extreme parallelism是怎么做的。 技术报告 *Serving Large Language Models on Huawei CloudMatrix384 用1机384节点来执行Deepseek R1 671B的推理,采用了3个优化 优化1 一个p2p的架构,将LLM推理拆解为prefill, decode, caching 优化2 large-scale expert parallelism fo…
PowerInfer: Fast Large Language Model Serving with a Consumer-grade GPU
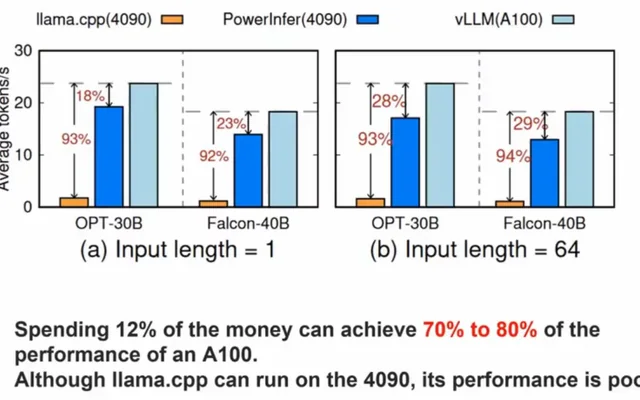
推理引擎会成为新时代的操作系统吗? RG-1210 PowerInfer: Fast Large Language Model Serving with a Consumer-grade GPU 2406.06282 【【RG 24 Fall】PowerInfer: Fast Large Language Model Serving with a Consumer-grad..】 https://www.bilibili.com/vi…
写博客的一周年
不知不觉中,我建立自己的博客已经有一年了。想在这里分享一些感悟。 我的大脑记忆像是一个随时丢失的网状数据库。丢失知识是常态,但因为知识之间有像网一样的连接,我们常能根据临近知识点推导或恢复出原本的内容。分布式存储里我们用奇偶校验构建容错,人脑里可能更像是一张知识网。虽然我们没有RAID,但我们有类比和抽象的能力。 当然,有一个强大的大脑加上不断的练习,可以构建一个不错的知识库。但有没有什么方式,可以用一个“普通大脑”也能拥有一个清晰的…
已弃坑:oneDNN架构解读
PS:这玩意已经不更新了,intel 放弃了哈哈哈哈哈哈哈。 https://zhuanlan.zhihu.com/p/20510564015 oneDNN是Intel开源的深度学习加速库,其前身为MKLDNN,对于Intel自家硬件(CPU以及GPU),oneDNN对神经网络算子的计算过程进行了针对性的优化处理,从而显著提升了神经网络算子在Intel硬件下的计算速度。在训练侧,oneDNN已作为第三方工具被目前几乎所有的主流训练框架…
自顶向下了解llama.cpp - ggml
由于工作要求,我尝试识读了llama.cpp框架在cpu端侧的推理情况。其实GPU端的结构我推测跟cpu差不多,只不过在底层算子会有区别,但是上层计算图等架构应该是差不多的。 好的,以下是我这个生成式AI给您生成的20000字长文(ChatGPT 也可能会犯错。请核查重要信息。): 学习链接 HF 导引 Introduction to ggml github源码 ggml 源码搭建 llama.cpp/docs/build.md at…
AlpaServe: Statistical Multiplexing with Model Parallelism for Deep Learning Serving
模型并行性通常被视为一种将单个大型深度学习模型扩展到单个设备内存限制之外的方法。在本文中,我们证明了在为多个模型提供服务时,模型并行还可以用于多个设备的统计多路复用,即使单个模型可以适应单个设备。我们的工作揭示了模型并行性引入的开销与利用统计多路复用来减少突发工作负载下服务延迟的机会之间的基本权衡。我们探索了新的权衡空间,并提出了一种新的服务系统 AlpaServe,它确定了在分布式集群中放置和并行化大型深度学习模型集合的有效策略。对…
硅谷101 AI应用如何全栈落地
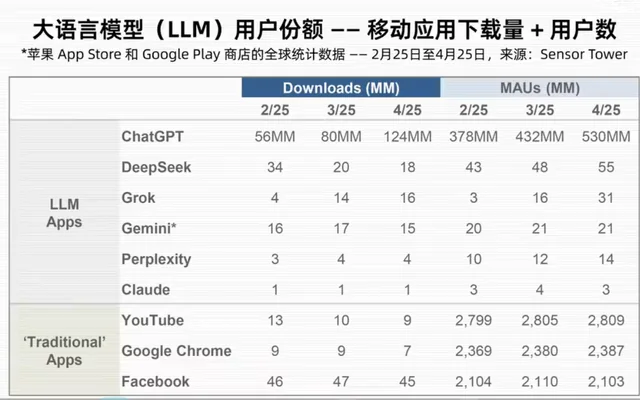
禁止转载! 【营销过后,AI应用如何落地?解析巨头们的“全栈之战”【硅谷101】】 https://www.bilibili.com/video/BV1bdTvz7EPx/?share_source=copy_web&vd_source=72eac555730ba7e7a64f9fa1d7f2b2d4 AI栈分3层 应用层:提供对应的服务,用户评论分析,搜广推 模型层:原始的LLM模型,如Transformer 计算层:底层硬件+软件…
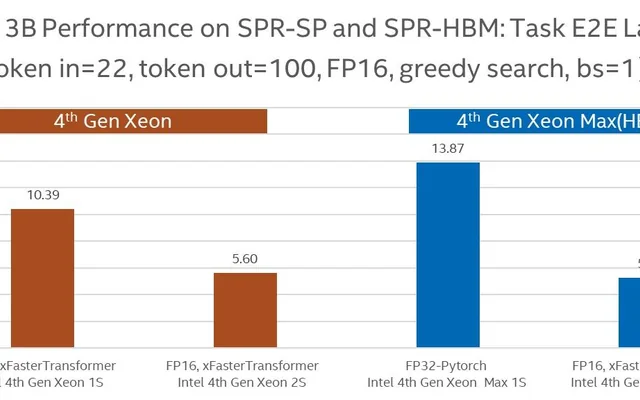
xFastTransformer 架构解读
省流:这东西2年前做的,最麻烦的是文档很少,基本都要从零开始研究代码,考虑时间成本我没有花很多精力。 如果大家想在单机上用CPU推理,也可以试试intel pytorch extension或者llama.cpp。(不过xFt相比他们俩的好处是,它的代码结构也相对比较简单易懂,大家都可以自由选择) 但是目前这个东西没有用计算图优化,它每次计算都要重开openmp并行域,感觉这会出点问题。 Examples — Intel® Exten…
ASPLOS08 - Overshadow: A Virtualization-Based Approach to Retrofitting Protection in Commodity Operating System
来自我的操作系统课的第二次Pre 这篇文章是在硬件虚拟化时代之前的科技与狠活 现有的保护应用的方法有从应用入手,从OS入手,从HW入手,从虚拟机入手。但是他们都有点昂贵,那我们能不能从VMM虚拟机管理器这个角度入手? 完整PPT Overshadow Overshadow 用了一个clocking的机制来确保要保护的程序不会被恶意程序访问
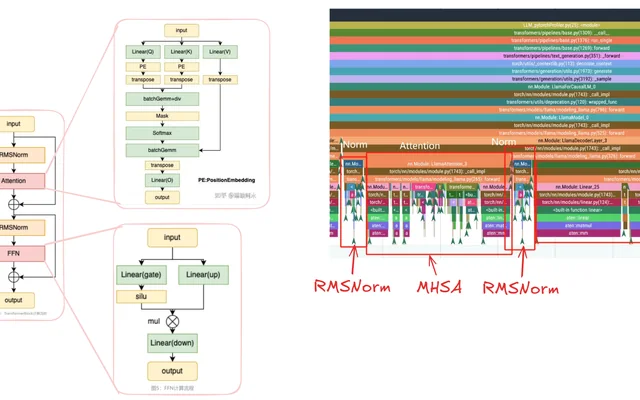
Pytorch ATen Matmul CPU 算子解析
在上一期 https://www.haibinlaiblog.top/index.php/llm-on-cpu/ , 我们探讨了各个LLM的具体结构,今天我们就来探寻这些结构/算子的底层实现。 上一期我们探讨的架构:LLM各阶段的代码在pytorch的实现 Pytorch调用栈解析 所以你这边就能看到Pytorch的调用核心逻辑了。它会先决定做什么算子,什么数据。然后回call_impl,此时它会根据之前的config(比如用GPU还…
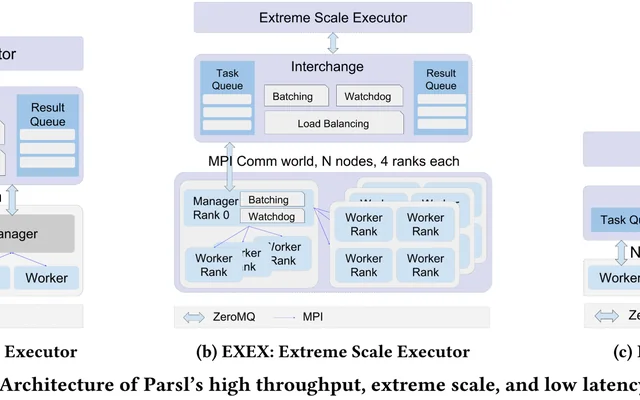
HPDC19: Parsl: Pervasive Parallel Programming in Python
《Parsl: Pervasive Parallel Programming in Python》,发表在HPDC '19会议上,作者来自芝加哥大学、阿贡国家实验室等机构。以下是对文章内容的简要介绍: 核心内容 文章介绍了一个名为 Parsl 的Python并行脚本库,旨在通过简单、可扩展和灵活的方式增强Python的并行编程能力。Parsl通过在Python中引入特定的构造(constructs),允许开发者轻松表达程序中的并行性…
Fail at Scale: Reliability in the face of rapid change
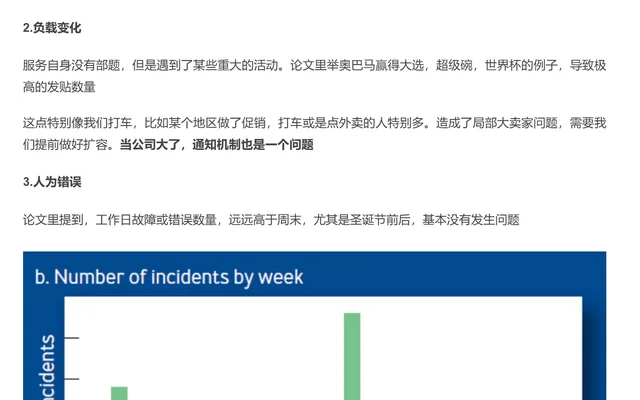
本keynote来自 Fail at Scale: Reliability in the face of rapid change Fail at Scale: Reliability in the face of rapid change: Queue: Vol 13, No 8 One of Facebook's cultural values is embracing failure. This can be seen in t…
Pytorch Intro: Everything you want to know
Pytorch 本质是和python完全不一样的东西。然后这东西本质是拿来训练模型的,其他的事情它干的一般般的。 学习链接 官方教程 Welcome to PyTorch Tutorials — PyTorch Tutorials 2.7.0+cu126 documentation Learning PyTorch with Examples — PyTorch Tutorials 2.7.0+cu126 documentation…
GNU OpenMP是怎么结束的
gcc/libgomp/config/posix/simple-bar.h at 4e47e2f833732c5d9a3c3e69dc753f99b3a56737 · gcc-mirror/gcc gcc/libgomp/parallel.c at e2bf0b3910de7e65363435f0a7fa606e2448a677 · gcc-mirror/gcc void GOMP_parallel_end (void) { stru…
X-Queue阅读
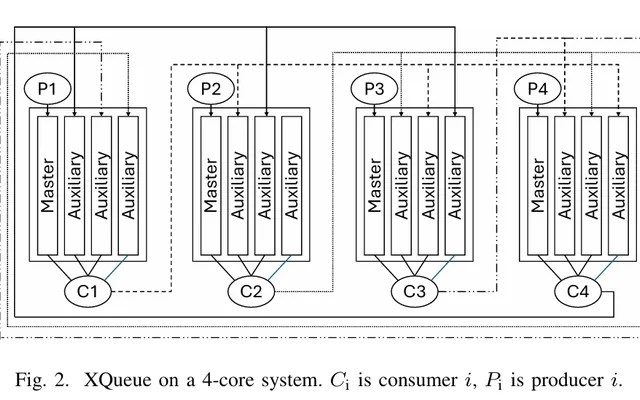
Abstract—Achieving efficient task parallelism on many-core architectures is an important challenge. The widely used GNU OpenMP implementation of the popular OpenMP parallel pro gramming model incurs high overhead for fi…
B-Queue
3_2.eps B-Queue 是一种面向多核架构中核间通信的高效、实用的 单生产者-单消费者(SPSC)无锁队列 ,其设计旨在解决现有并发无锁队列(CLF queue)在真实应用中存在的性能退化与死锁难题。 背景动机 多核系统中,线程间通常通过共享内存进行通信,CLF 队列被广泛用于核心间通信。然而现有的方案(如 FastForward 和 MCRingBuffer)存在如下问题: 性能仅在理想条件(如 L1 缓存驻留)下突出 ,在…
gcc是如何实现OpenMP parallel for的
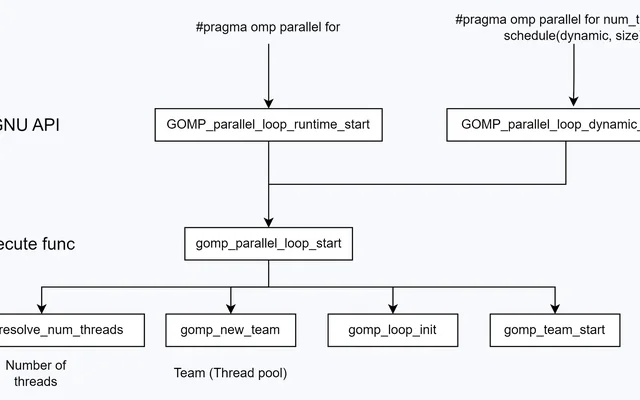
学习网页 本次我们主要会聚焦team.c 和loop.c: gcc/libgomp/loop.c at master · gcc-mirror/gcc gcc/libgomp/team.c at master · gcc-mirror/gcc OpenMP For Construct dynamic 调度方式实现原理和源码分析 - 一无是处的研究僧 - 博客园 TL; DR TL;DR: 大概idea就是,先分块,后并行。并行的模块我…
gcc是怎么实现OpenMP的?
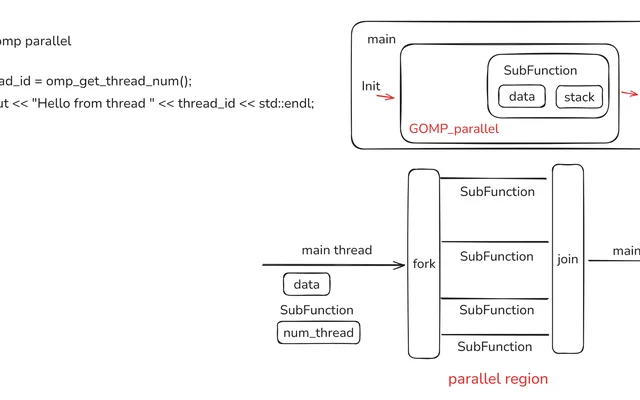
由于网上关于GNU openmp的解构比较少,今天我由于工作问题,我也来亲自解答:“为什么OpenMP不能完成 “小而多的并行任务” 的问题。(llvm的解构我之前在博客已经做过 llvm 如何实现OpenMP ,其实从结构来看,跟OpenMP的结构基本一致,都遵从OpenMP官方的fork-join 的idea,但是llvm的实现会比较复杂) 学习网页 我们所有的学习都可以从这里出发: 源码 doxygen文档: Libgomp:…
OpenMP的barrier同步
do_release: if (nested) gomp_barrier_wait (&team->barrier); else gomp_simple_barrier_wait (&pool->threads_dock); /* Decrease the barrier threshold to match the number of threads that should arrive back at the end of thi…
OpenMP 绑定核跟线程
for (; i < nthreads; ++i) { int err; start_data->ts.place_partition_off = thr->ts.place_partition_off; start_data->ts.place_partition_len = thr->ts.place_partition_len; start_data->place = 0; if ( (gomp_places_list != N…
proc_bind 各策略的 place 计算逻辑、affinity_thr 的内存管理,gomp_simple_barrier_reinit 如何保证同步
很好!你提的这三个点都直指 GOMP_parallel 线程调度核心机制。我们逐一详细剖析这三项: 🔢 一、 proc_bind 各策略下的 place 计算逻辑 这个逻辑体现在你贴出的代码中 switch (bind) 语句块下的 线程 affinity 计算部分 ,其作用是:为第 i 个线程计算它应绑定的 place_partition_off 和 place_partition_len 。 proc_bind(master) 策…
My CV 2025-5-27
https://www.haibinlaiblog.top/wp-content/uploads/2025/05/Haibin_CV-2.pdf [pdf-embedder url="https://www.haibinlaiblog.top/wp-content/uploads/2025/05/Haibin_CV-2.pdf" title="Haibin_CV (2)"]
OpenMP在gcc里是如何启动的?
图片未显示锁竞争(Lock Contention = 0s),表明 PyTorch 或 MKL 可能绕过 GOMP 的全局任务锁,使用原子操作或分区任务。 /* This structure is used to communicate across pthread_create. */ struct gomp_thread_start_data { void (*fn) (void *); void *fn_data; struct…
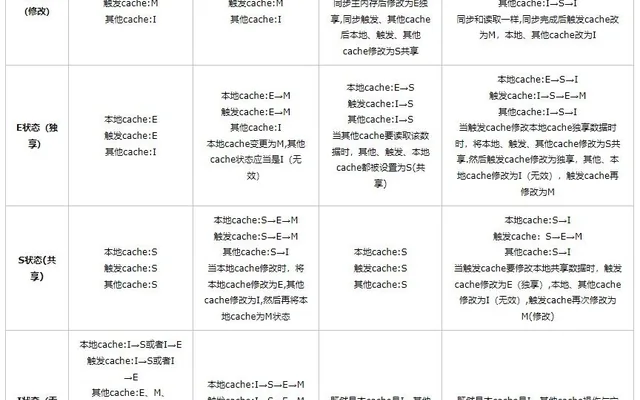
微专题:MESI
全知乎最详细的并发研究之CPU缓存一致性协议(MESI)有这一篇就够了! - 知乎 多核CPU多级缓存一致性协议MESI 多核CPU的情况下有多个一级缓存,如何保证缓存内部数据的一致,不让系统数据混乱。这里就引出了一个一致性的协议MESI。 MESI协议 缓存状态 MESI 是指4中状态的首字母。每个Cache line有4个状态,可用2个bit表示,它们分别是: 缓存行(Cache line):缓存存储数据的单元。 状态 描述 监听…
书籍阅读《分布式系统》
第一章 特征 分布式系统特征 并发 缺乏全局时钟 故障独立性 例子 :Web、大型多人在线游戏MMOG、金融交易 趋势 泛在联网技术:设备可在任何时间地点连接 Ubiquitous Computing 什么是UbiComp普适计算(泛在计算)?它与IoT物联网有哪些联系与区别?-云社区-华为云 无处不在计算:任何设备都可以计算 分布式多媒体系统:音频、视频、电话支持;编解码支持、QoS、资源调度 公共设施化:用户可租聘;SaaS、云计…
1-bit量化
用AI生成的。省着点看。 1-bit大模型指的是采用1-bit量化(即权重仅用+1或-1表示)的神经网络模型,具体在本文件中指的是 BitNet ,一种专为大规模语言模型设计的1-bit Transformer架构。以下是关于BitNet和1-bit大模型的关键点总结: 1. 什么是BitNet? BitNet 是一种1-bit Transformer架构,通过将模型权重量化为1-bit(二值化,+1或-1),并结合量化激活(如8-b…
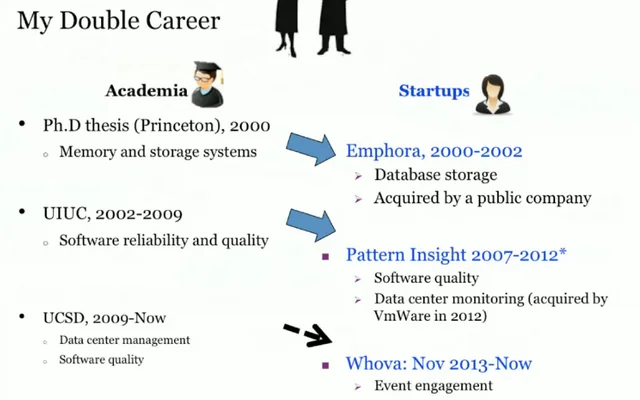
Yuanyuan Zhou 教授创业分享
非常推荐大家看看周源源教授在系统方向创业的分享 https://www.youtube.com/live/KTcu33RghQs?si=a14SjuAE1V78sh3W Bio: Yuanyuan Zhou (周源源)is a Qualcomm Chair Professor in Mobile Computing at University of California, San Diego (UCSD) since 2009. Pr…
git 文件太大了怎么办
给我这个沙比买单: git log 查看之前的提交记录 git reset [HEAD] 回退到某一个版本 这样操作不会删除本地记录,并且能回退 git status查看状态
转自我在中学博客的留言:毕业5年,回校看看
转载自我在中学博客上的留言. 今天在填表时,我需要填写我的中学经历。时间久远,我忘记了中大附中在哪。当我查到新港西路135号时,我无意间竟来到了这里,5年前的班级博客。 记得当时我是班博的管理员。在博客建立后,我曾呼吁大家来这里踊跃投稿。从历史的遗迹来看,投稿的量确实挺不错,虽然有大概一半可能是我自己和周围同学的稿件,还有一些为了水文字而二投的作品。当时大家好像不是很愿意投稿,我怂恿大家说,每投一篇稿,会有稿费!但是这稿费到底是否有…
MoE-Sys 文章记录
MoE Survey withinmiaov/A-Survey-on-Mixture-of-Experts-in-LLMs: The official GitHub page for the survey paper "A Survey on Mixture of Experts in Large Language Models". 一文弄懂Mixture of Experts (MoE)的前世今生 - 文章 - 开发者社区 - 火山…
Buffer Overflows: Attacks and Defenses for the Vulnerability of the Decade
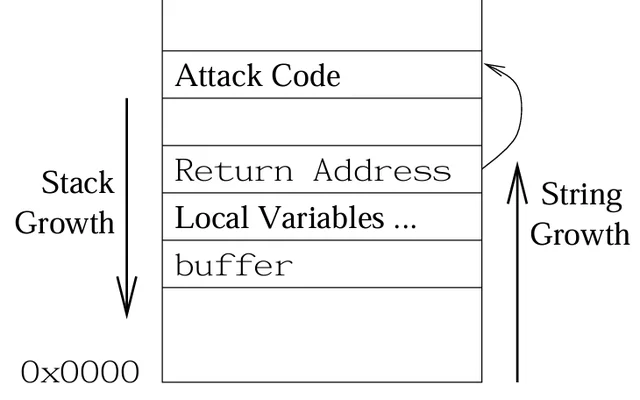
总结性的原文 USENIX Security 1998 Buffer Overflows: Attacks and Defenses for the Vulnerability of the Decade Crispin Cowan, Perry Wagle, Calton Pu, Steve Beattie, and Jonathan Walpole [Buffer overflows: attacks and defenses f…
System Research 研究周期
我们把我们的研究分为了6个周期 节点1:规划 规划project task,建立对该领域的视野 思考目前sota的方向还没有完成的地方 列出可能的project task,针对每个task的竞争程度和发展程度,制定符合个人能力的project task 视野 研究领域:GPM、SM在并行计算、GPU计算中的应用。 静态图sota G2Miner/Mercury 他们很好的用GPU解决的GPU并行来处理静态图的GPM算法 动态图/Con…
MPI: old learning
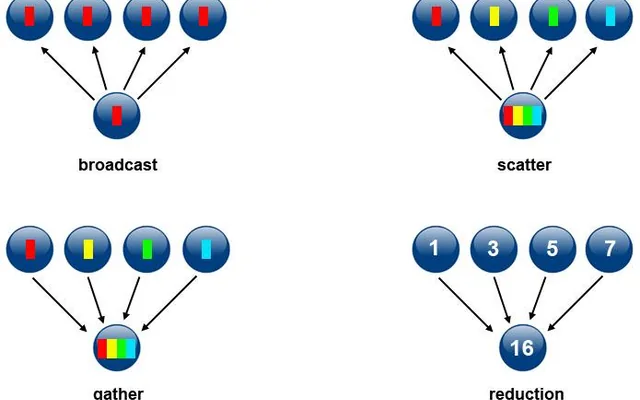
Tutorials · MPI Tutorial 其实这个问题背后很有意思。mpi属于hpc领域,和现在的hadoop生态本来就不属于一块。 个人觉得一个技术能否流行起来,主要取决于三点:自身性能,易用性,环境。 性能上,mpi适用于计算密集型,在对计算要求比较高的地方,确实比hadoop/spark用的广,比如机器学习, 生物计算 。但是属于io密集型就不会有优势,很多 大数据 任务属于这种情况。 易用性上,mpi无论是编写和运行环…
CXL技术:历史、技术与展望
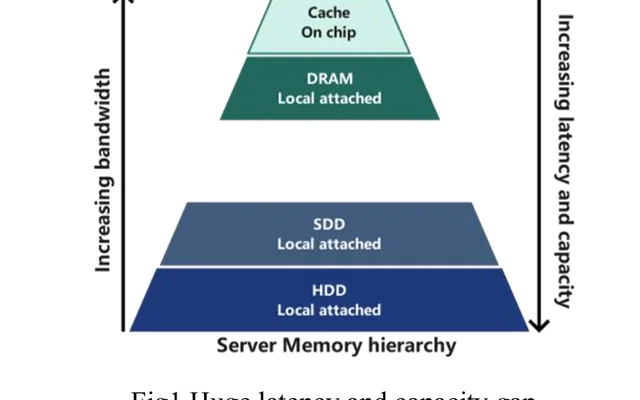
Research on the CXL Memory CXL (Compute Express Link) 技术是一种基于PCIe IO的缓存一致性互联标准, 其旨在提供主机处理器与加速器、内存缓冲器和智能 I/O 设备之间的高带宽、低延迟连接。 CXL在延迟和带宽方面比传统的远程直接内存访问(RDMA)技术有所改进,基于 CXL 内存的存算分离架构的趋势会继续,更多标准化和生态开发会出来。但在处理高并发和高吞吐量任务时,与本地内存相…
std::unordered_map
是的, std::unordered_map 的本质是 哈希表 ,而 std::map 是基于 红黑树 的有序容器。 让我们来详细了解一下 哈希表 是如何实现的,特别是在 unordered_map 中是如何工作的。 1. 哈希表的基本原理 哈希表是基于哈希函数的概念,哈希函数将 键(key) 转换为一个固定大小的数组索引。哈希表的核心结构通常是一个数组,数组中的每个位置叫做 桶 。元素通过哈希函数计算得到哈希值,然后将元素存放到对应…
Scalability! But at what COST 文章介绍
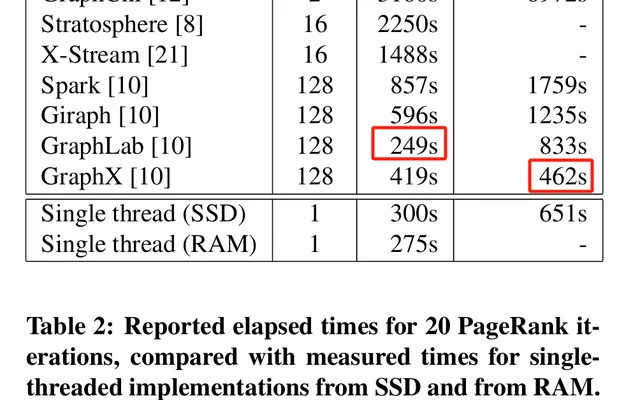
Scalability! But at what COST 文章介绍 hotos15-paper-mcsherry.pdf 这篇文章讲了一个很重要的问题:在图计算这一领域中,我们要去思考,Scalable是否真的带来Effective? 即使算法的逻辑(如PageRank的迭代公式)看起来相同,分布式系统的实现方式(通信、同步、数据分区、语言开销)引入了大量额外工作,导致性能低于单线程。 多线程或分布式系统的性能不如单线程,可以用一个…
LLM Parameter Estimation
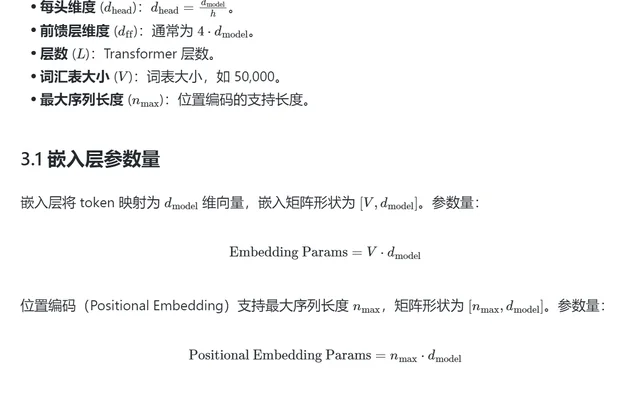
大模型参数量估计推导 1. 为什么需要估计参数量? 大模型(如 BERT、GPT、LLaMA)参数量通常亿级甚至万亿级,估计参数量有助于: 硬件需求评估 :参数量影响内存和计算资源需求。 模型规模比较 :参数量反映复杂度和潜在能力。 优化设计 :在资源有限时,调整结构以平衡性能和效率。 参数量由模型的各个组成部分(层、权重矩阵、偏置等)决定,以下以 Transformer 架构为例推导。 2. Transformer 架构核心组件 T…
Linux如何把运行程序从一个CPU核切换到另一个核
为什么会出现cpu使用率偶数核比奇数核高 - 知乎 Linux 通过以下机制实现多核识别和任务并行分配: 识别多核硬件 : Linux 内核在启动时通过 CPU 拓扑信息 (从硬件和固件获取)来检测系统中可用的 CPU 核心数量和特性。这些信息通常由 ACPI(高级配置与电源接口) 或 Device Tree 提供。 内核通过读取 /proc/cpuinfo 或 sysfs (如 /sys/devices/system/cpu/ )中…
计算机体系结构未来发展预测
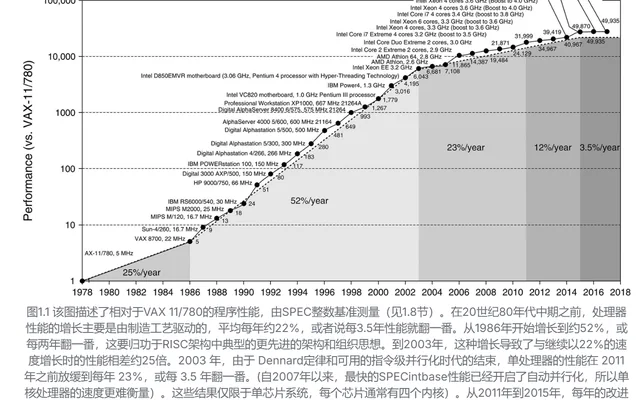
tldr: 专用的硬件将成为计算主流 多节点情况下,CPU的核数将稳定保持在16-48核内。多节点的目标不再是更多CPU,而是能控制更多GPU等特殊硬件 特殊内存、特殊网络通信等组件将更加主流 云服务主导,个人与仓储计算差异化 软件-硬件协同设计 可持续计算,能耗成为一个关键因素 计算机CPU性能增长缓慢 下文来自David Pattersen的《计算机体系结构:量化研究方法》: 提高能效-性能-成本的唯一途径是专业化。 时钟增长缓慢…
LLM on CPU 推理流程python源码解析
其他框架解析: vllm 框架解析: LLM 高速推理框架 vLLM 源代码分析 / vLLM Source Code Analysis - 知乎 vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention | vLLM Blog llama.cpp llama.cpp源码解读--推理流程总览 - 知乎 纯新手教程:用llama.cpp本地部署DeepSeek蒸馏模型 - 知…
Worst-Case Optimal Join
最坏情况下最优连接(Worst-Case Optimal Joins) - 知乎 _Amine Mhedhbi and Semih Salihoglu. 2019. Optimizing subgraph queries by combining binary and worst-case optimal joins. Proc. VLDB Endow. 12, 11 (July 2019), 1692–1704. DOI: http…
HGEMM
赖海斌 ROI on HGEMM 矩阵参数 不同size的标准矩阵: 32 256 2048 8192 16384 32768 ...... 矩阵形式: 正常矩阵(256 X 256) 特殊形状矩阵(有边界条件) 257 2049 // ? 稀疏矩阵(不同处理方式)// ? 复杂矩阵(行列相差极大,如 M=2048, N=8, K=2048) API GEMM API void hgemm(const float16_t* A, co…
LLM Pytorch Profiling on CPU
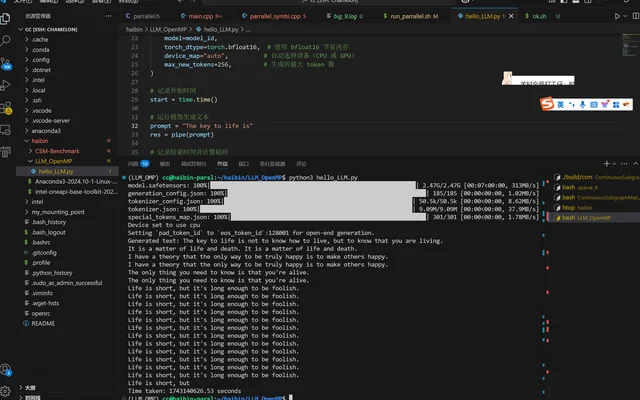
This passage is for my own profile for LLM meta-llama/Llama-3.2-1B We do an indepth analysis for LLM using pytorch profiler and Intel Vtune life is short, but it’s long enough to be foolish import torch from transformer…
Pokemon TCGP Highlight
Pokemon!!!!
SC 2024 文章简介及相关解读
为了寻找下一阶段的工作,同时思考我未来要做什么,我就将 SC 24大概90 篇文章都读了一遍. 这个栏目是我为了学习HPC而创建,我的解读目的在于了解以下问题: 研究的问题 HPC方向,大家都关注什么? 有哪些方向? 大家都在做什么? 常见的优化手段有什么? 做的工作需要哪些背景? 需要数学, 材料, 计算中心, 企业应用, 科学计算程序的相关经验? 文章的知识背景有哪些? 问题是从哪里来的? 工作的数据从哪里来的? 我们需要什么样的…
SC Paper Summary 5
总链接: https://www.haibinlaiblog.top/index.php/sc-2024-passage/ Matrix Computations on Tensor Cores AmgT: Algebraic Multigrid Solver on Tensor Cores (Best Paper Finalist) Super Scientific Software Laboratory, Dept. of CST…
科研牛马如何建立笔记体系
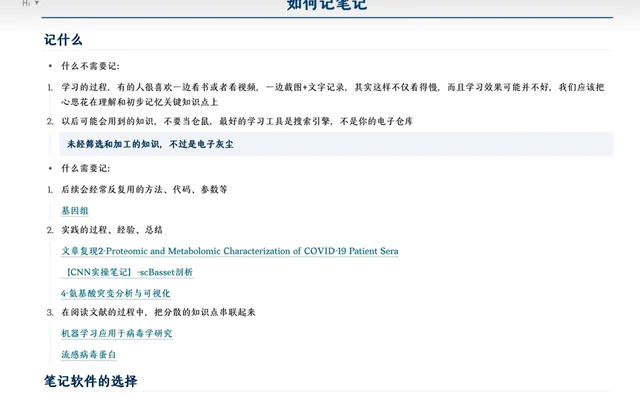
这是一个持续更新的笔记记录,留给自己警示。 https://www.bilibili.com/video/BV1vqXRYDEfD/?spm_id_from=333.1007.tianma.12-3-45.click&vd_source=4871cfa497362c1a843af2ecff18ab7f
SC 24 Brief Summary 4
总链接: https://www.haibinlaiblog.top/index.php/sc-2024-passage/ Parallel Program Analysis and Code Optimization MCFuser: High-performance and Rapid-fusion of Memory-bound Compute-intensive Operators Authors: Zheng Zhang…
SC Paper Reading 3
总链接: https://www.haibinlaiblog.top/index.php/sc-2024-passage/ Paper Computational Efficiency and Learning Techniques Murali Emani B311 AcceleratorsApplications and Application FrameworksArtificial Intelligence/Machine L…
PRAM, BSP, logP Model
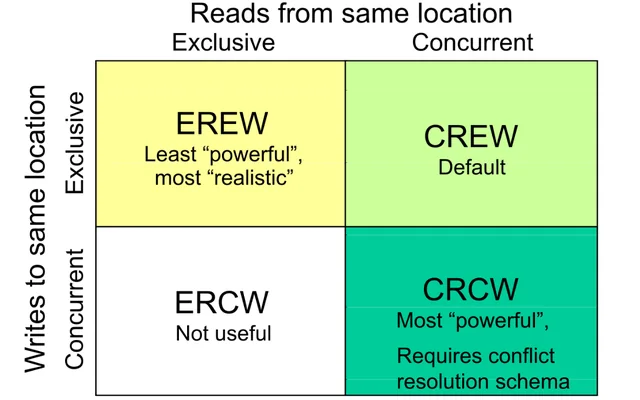
简单介绍 PRAM 、 BSP 和 logP 这三种并行计算模型。 学习参考链接: 《高性能计算与云计算》第五讲并行算法设计 - 豆丁网Docin 1. PRAM(Parallel Random Access Machine)模型 PRAM 是一种理想化的并行计算模型,用来描述并行算法的运行方式。你可以把它想象成一个理想的并行计算机,具有无限多个处理器(CPU),这些处理器可以 同时访问 共享的内存。 特点 :所有的处理器可以 同时读…
RAG、GraphRAG介绍
本文是对这两个概念的转载与学习 部署效果: RAG介绍 1 2 3 检索增强生成(RAG) 是一种结合信息检索和生成模型的技术,用于提高大语言模型(LLM)的回答准确性和深度 1 2 。 检索增强生成(Retrieval Augmented Generation,RAG)整合了从庞大知识库中检索到的相关信息,并以此为基础,指导大型语言模型生成更为精准的答案,显著提升了回答的准确性与深度。 LLM 擅长语言理解、推理和生成等任务,但也存…
HPL Assignment: Intro
IndySCC 的HPL基础测试报告 https://www.haibinlaiblog.top/wp-content/uploads/2024/09/HPL-Assignment.pdf
OpenMP在llvm里是如何实现的?
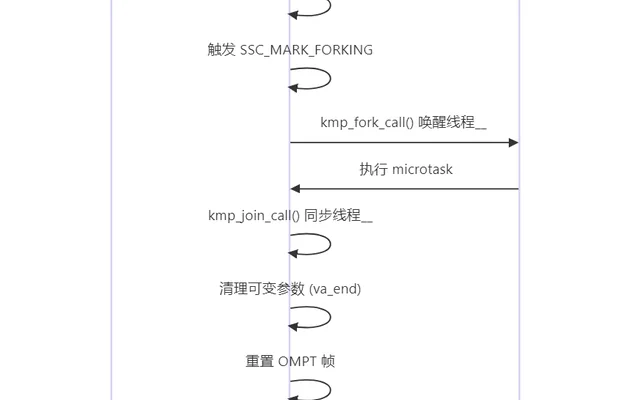
基础知识:编译器的结构 编译器中的“前端”和“后端”是两个重要的组成部分,它们负责编译过程的不同阶段。我们可以将编译器看作一个“处理流水线”,前端和后端各自执行不同的任务。 前端 :负责将源代码解析成抽象语法树并生成中间代码,确保代码的语法和语义正确。 词法分析、语法分析、语义分析和中间代码生成。 后端 :负责优化中间代码并生成目标机器代码,最终输出可执行文件。 优化、目标代码生成、汇编、链接。 前端(Frontend) 编译器的前端…
FL-studio入门
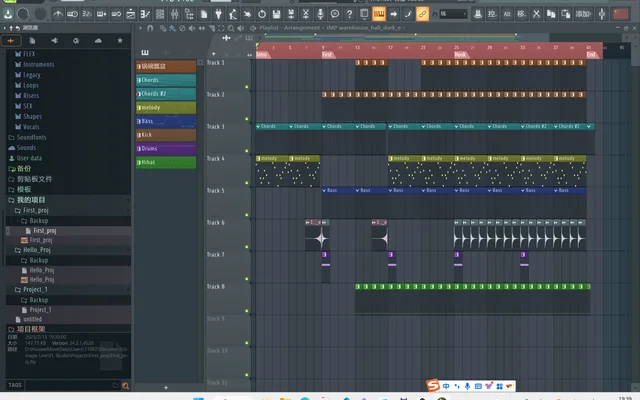
FL-studio的兴趣学习 写的新歌曲 [audio mp3="https://www.haibinlaiblog.top/wp-content/uploads/2025/02/First_proj.mp3"][/audio]
新的哈希结构:漏斗哈希
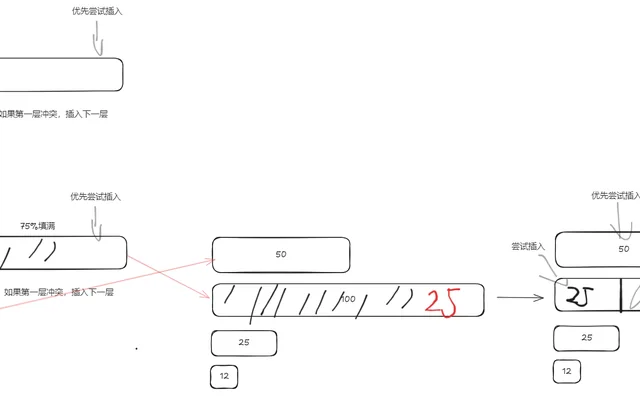
本科生推翻姚期智40年前的猜想,提出全新哈希表算法突破搜索效率极限 https://news.qq.com/rain/a/20250211A04F8H00 我们可以看看它的文章: https://arxiv.org/pdf/2501.02305 这篇文章提出了一个漏斗哈希,在第三节 Funnel Hashing 原本的哈希表经过哈希函数后随机探测位置,找到位置就把数值分配。而它的漏斗哈希会把数组分为多个2倍数的子数组,他们构成一个漏斗…
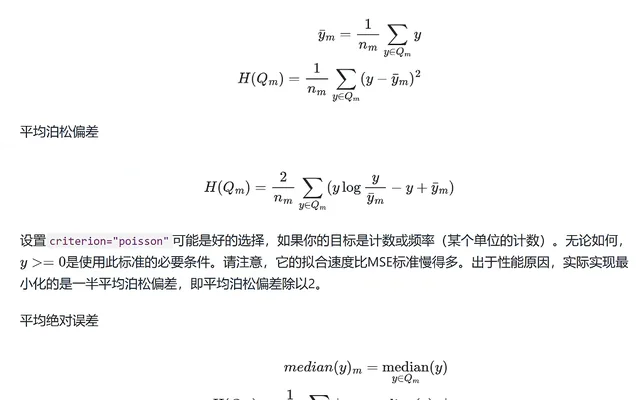
回归决策树
sci-kit learn 参考 https://scikit-learn.cn/1.6/modules/tree.html 决策树使用树(或者不雅观的说,使用几个嵌套if)来对数据进行分类。决策树的树种类不同,就造就了不同的模型,比如XGBoost,LightGBM。 在 决策树算法 中, 分裂增益 (Splitting Gain)通常指的是在选择分裂特征时,分裂某个特征对决策树模型性能的提升。这个提升通常是通过评估 信息增益 (I…
数据流挖掘
https://dm-trans.github.io/DM-trans/12/ “教育不是学习,信息,数据,事实,技能或能力的堆砌,这是培训或教学。教育是让隐藏的种子变得可见。” - Thomas More 介绍 硬件技术的进步已经衍生出以比以前更快的速度收集数据的新方法。 例如,许多日常生活交易(例如使用信用卡或电话)导致自动收集数据。 同样,收集数据的新方法(例如可穿戴式传感器和移动设备)也增加了动态可用数据的洪流。 这些数据收集…
转载:glibc malloc的底层原理
原作者: https://sploitfun.wordpress.com/2015/02/10/understanding-glibc-malloc/comment-page-1/?blogsub=confirming#subscribe-blog%E3%80%82 中文翻译原作: https://blog.csdn.net/maokelong95/article/details/51989081 https://zhuanlan.z…
读书:分布式计算、云计算与大数据
图书馆里尻来的老书,总的来说,给小朋友介绍挺不错的。但是可惜太学院派,缺少真实实战。 [3d-flip-book id="603" ][/3d-flip-book] 云计算的基础 定义/概念: 并行计算、网络计算、对等计算、集群计算、网格计算、云计算、边缘计算、移动边缘计算、大数据 分布式计算依赖于多个计算节点共同协作来处理任务。其不同于C/S架构,还要多节点要协同通信。 主要应用: GIMPS梅森素数 SETI@Home Amazo…
Experiment
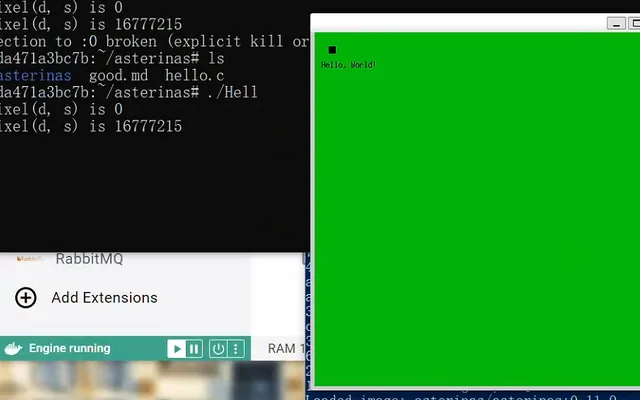
Run on WSL Setup WSL X11 environment Run the image # load asterinas 0.11.0 docker load -i .\asterinas.tar # run the image with X11 forwarding sudo docker run -it --privileged -v $(pwd)/asterinas:/root/asterinas -e DISPL…
Risgraph
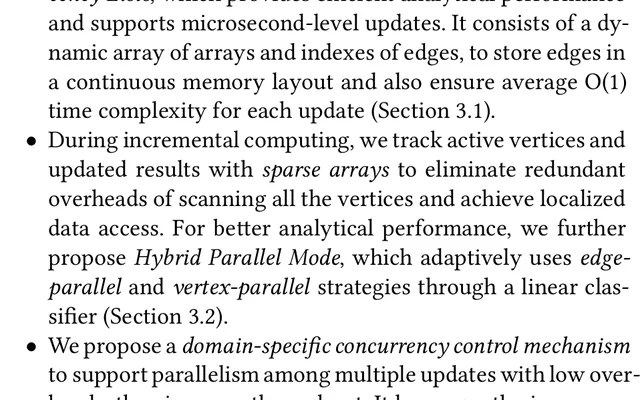
RisGraph: A Real-Time Streaming System for Evolving Graphs to Support Sub-millisecond Per-update Analysis at Millions Ops/s low latency and high though put Batch 能解决 high thoughput , 但是很多信息消失,同时实时性不够 stream 能解决 low late…
Machine Learning: CrashSceneGen
ML_DM_No_video ML_DM_No_video
《在轮下》黑塞
中学的时候有次作文,主题是“人生是一场马拉松”。它告诉我们人生要合理规划,不断坚持。但我当时思维比较散,我觉得,这个世界有千万亿人,为什么大家都要在一个狭长的赛道奔跑?比起固定的行进路线,大家的轨迹不应该是四周发散的? 老师给了我38分,批评我偏题了,观点完全不在得分点上。 “亲爱的,千万别松懈,要不然就会滚到车轮底下去”。 受几个朋友推荐,前些天我读了黑塞的《在轮下》。读完后百感交集,但却一直没有办法抒发自己完整的想法。 这本书讲述…
ConvStencil
一个讲的挺不错的组会 https://www.haibinlaiblog.top/wp-content/uploads/2025/01/ConvStencil1.pdf
[WIP] 实验:用gdb观察gdb
Can I use gdb to observe gdb? I always forget how gdb was made. for me, I went though the website on stackoverflow of Zhihu serveral times only for this question, and I always forget everything about ptrace . And I thin…
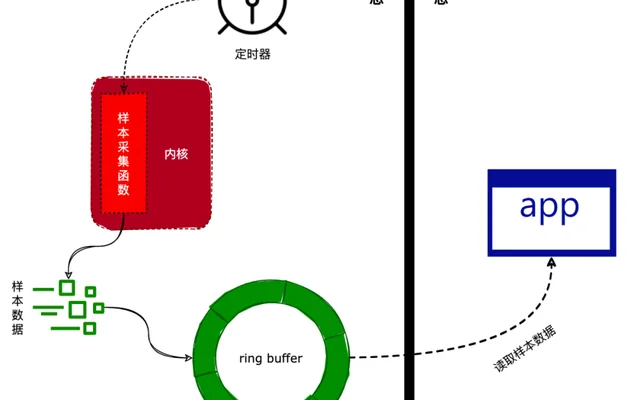
[WIP] Perf 是怎么做的
好像跟gdb怎么做的还是有差别的 gdb用的ptrace 【一文看懂 | GDB 底层实现原理】【转载】_gdb底层原理-CSDN博客 用图文带你彻底弄懂GDB调试原理-腾讯云开发者社区-腾讯云
Ajax底层是怎么做的
省流:HTTP通信+XML数据结构 AJAX(Asynchronous JavaScript and XML)的底层原理涉及浏览器与服务器之间的异步通信。AJAX 的关键在于通过 JavaScript 实现网页的异步请求,而不需要重新加载整个页面。它使得网页可以在不干扰用户操作的情况下,部分更新页面内容。其底层原理主要涉及以下几个方面: 1. XMLHttpRequest 对象 XMLHttpRequest (XHR)是 AJAX 的…
Operating System Assignment 7
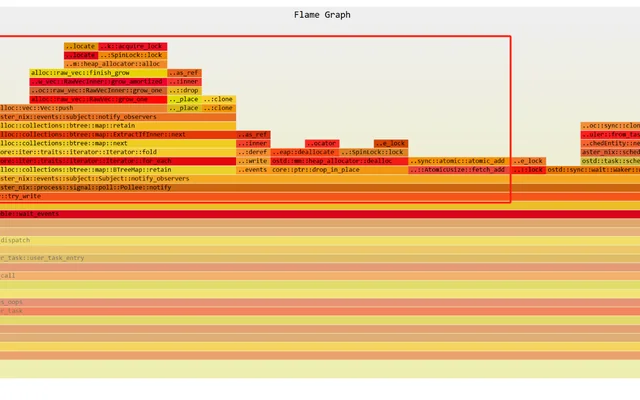
OpHaibin Lai 12211612 在实验室服务器玩的时候,宕机了5次,Asterinas的profile模式似乎会逐渐把tcp堵死,然后就连不上机器。差点被学长学姐杀了( 本次作业将分成如下几个部分: 执行的环境脚本和命令脚本(pipe_lat) lmbench测试结果与gdb profiling情况 OS pipe管道介绍与Asterinas pipe源码学习 gdb flame graph Observation与Mot…
Operating System Assignment 4
Author: Haibin Lai 12211612 OS: Virtual Memory - Haibin's blog Q1 Explain how do the CPU hardware and the operating system cooperate in the procedure of address translation. Ans: The hardware-based address translation i…
How can lscpu get Cache size
Since Operating System corporate little with Cache, How can lscpu knows the size of them? The CPUID Explorer: Part 2 Answer: CPUID Register From CPUID register! CPUID is an instruction in x86 and x86-64 processors that…
OS Assignment 5
赖海斌 12211612 1. Question1 [50pts] In a demand-paging memory management system, suppose the page table contents for a certain process are as follows (for a single-level page table, with H denoting hexadecimal values): Vi…
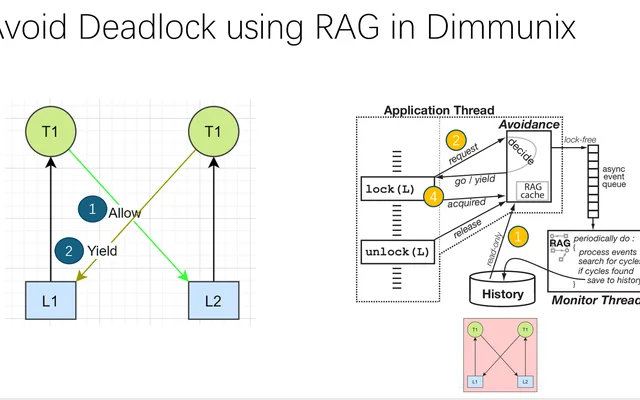
Deadlock Immunity
OSDI08: Dimmunix Deadlock immunity My PPT OSDI08: Deadlock immunity
时间、运动与芝诺:古希腊悖论的现代解读
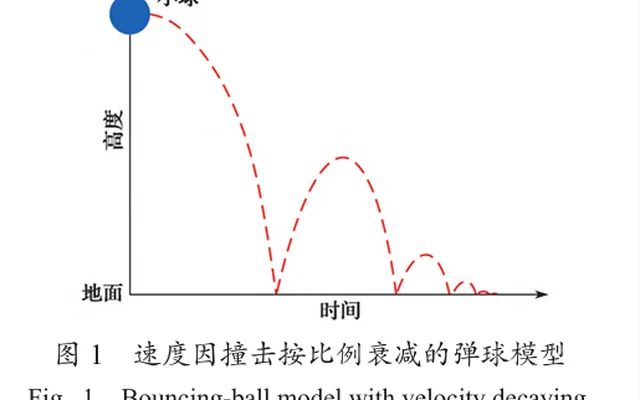
时间、运动与芝诺:古希腊悖论的现代解读 摘要:古希腊哲学家芝诺为回击对他所属学派的驳斥,提出了影响后世深远的芝诺悖论。芝诺悖论让我们重新思考时间与空间的变化问题,推动着数学中极限与物理学中运动的发展,并出现在当今的混沌动力学与量子芝诺效应中,让这一古老的悖论在今天仍值得不同角度的解读。 关键词:芝诺悖论;时间变化; 一、引言 芝诺·埃利亚(Zeno of Elea,此处与斯多葛学派创始人Zeno of Citium区分)是一位希腊哲学…
SC 24 Brief Summary 2
总链接: https://www.haibinlaiblog.top/index.php/sc-2024-passage/ ChatBLAS: The First AI-Generated and Portable BLAS Library 用GPT写的BLAS库 ChatBLAS: The First AI-Generated and Portable BLAS Library We present ChatBLAS, the fi…
Bigtable: The beginning of Big Data
Bigtable is a distributed storage system for managing structured data that is designed to scale to a very large size: petabytes of data across thousands of commodity servers. GFS的出现虽然解决了海量数据的存储问题,但是还是存在一个问题就是如果我存放的数据是结构…
Induced Graph 诱导子图
在图论中, 诱导子图 (Induced Subgraph)是从一个图 ( G ) 中通过 (1) 选取一个顶点子集 ( S ) 并 (2) 保留与这些顶点相连接的边来构造的子图。具体地说,诱导子图包含了选定顶点的所有邻接边。 定义 给定一个图 $G = (V, E)$ ,如果从 ( G ) 中选择一个顶点子集 ( S \subseteq V ),那么 诱导子图 ( $G[S]$ ) 是由顶点集 $S$ 和边集 $E'$ 组成的图,其中…
OS Project part I VirtIO, a biref summary
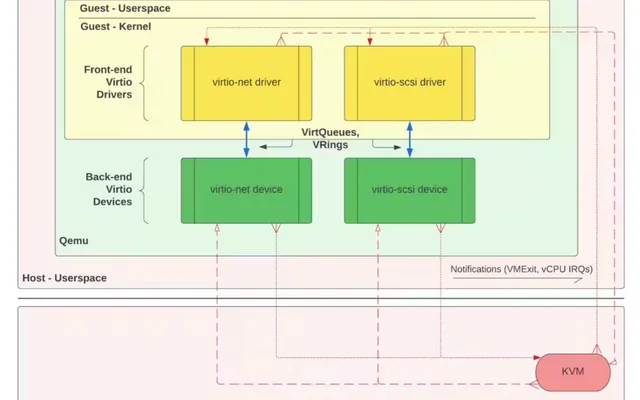
制作基于VirtIO设备驱动 设备驱动需要做什么? 设备初始化 从硬件读取数据,将数据传送进内核 读取内核数据,写入硬件 检测和处理设备错误 Intro: 虚拟化 全虚拟化 是指 虚拟化软件 (VMM)遵循硬件的规范,完整模拟硬件逻辑,这种方式对 guest 操作系统是透明的,即 guest 操作系统不需要做任何修改。全虚拟化模拟的设备与硬件设备对于 驱动程序 并无不同。全虚拟化的设备性能较低,因为完全按照硬件的规范来模拟硬件逻辑,这…
OS: Virtual Memory
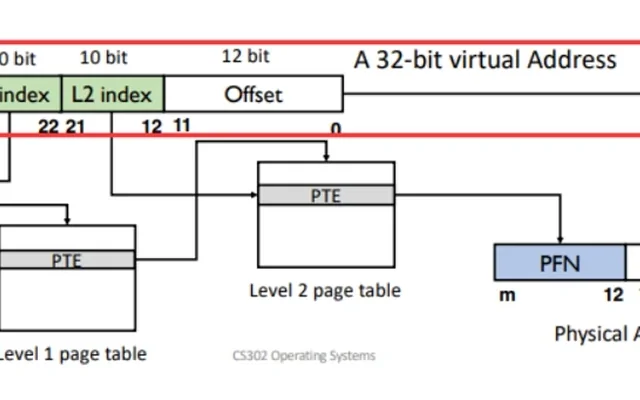
Author: Haibin Lai 12211612 OS: Virtual Memory - Haibin's blog Q1 Address Translation Explain how do the CPU hardware and the operating system cooperate in the procedure of address translation. Ans: The hardware-based a…
TLB, ASID, TTBR And Context Switching
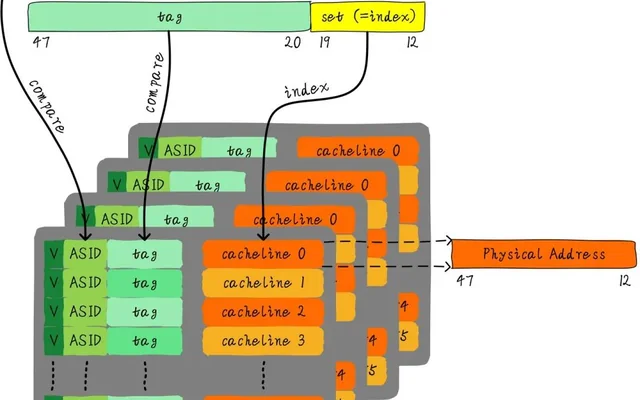
本文是在实验课上看一些文章和GPT整理的,不完全 Linux内存管理笔记----TLB-阿里云开发者社区 面试官:不同进程对应相同的虚拟地址,在 TLB 是如何区分的?-腾讯云开发者社区-腾讯云 Linux进程管理+内存管理:进程切换的TLB处理(ASID-address space ID、PCID-process context ID)_进程的asid-CSDN博客 TLB、PCID与ASID的故事_pcid机制-CSDN博客 1…
Cache Bypassing
记录一个技术。文章用GPT生成的。 Cache Bypassing 是一种计算机体系结构中的优化技术,它通过直接将数据从主内存传送到处理器,而绕过处理器的缓存(cache)层级。通常,处理器缓存(如L1、L2缓存)用于减少访问主内存的延迟,但在某些情况下,绕过缓存可能是更高效的选择。 Cache Bypassing的背景 处理器缓存是一个快速的存储层次,用来减少访问主内存的时间。数据通常被加载到缓存中,当处理器需要访问这些数据时,它首…
SC 24 brief Summary 1
SC 24 Passage My summary and understanding of the papers presented at the SC24 conference. 总链接: https://www.haibinlaiblog.top/index.php/sc-2024-passage/ Jensen Huang NVIDIA speech 主题:NVIDIA GPU的历史、目前进展与突破,在CFD、蛋白质等科学计算、…
APAC 2024 Optimization Summary: HPC
HPC Groups: ZuDong Li (leader) Haibin Lai Benxiang Xiao Zixu Wang Wenhan Tan Wenbo An AI Groups: Yukun Yang Honglie Li Junyu Su Abstract In this report, we detail the optimization efforts conducted on two key applicatio…
CSR与邻接表的内存开销对比
邻接列表(Adjacency List) 和 压缩稀疏行(CSR,Compressed Sparse Row) 是两种常见的图表示方法,它们的空间效率在不同情况下有所差异。具体来说,哪个表示法更节省空间,取决于图的稀疏程度和实际的存储需求。 1. 邻接列表(Adjacency List) 在邻接列表中,每个顶点有一个列表,存储与该顶点相邻的所有顶点。每个顶点的邻接列表可能包含不同数量的邻居,因此每个顶点的存储大小是变化的。 结构 :…
A Standard for the Transmission of IP Datagrams on Avian Carriers
基于信鸽的IP网络传输 This protocol is in RFC 1149 version https://datatracker.ietf.org/doc/html/rfc1149 A Standard for the Transmission of IP Datagrams on Avian Carriers Status of this Memo This memo describes an experimental me…
HPL 浮点数理论性能与实际性能相差6倍问题
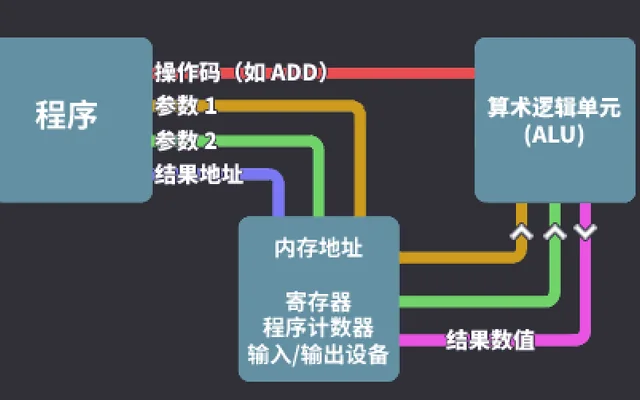
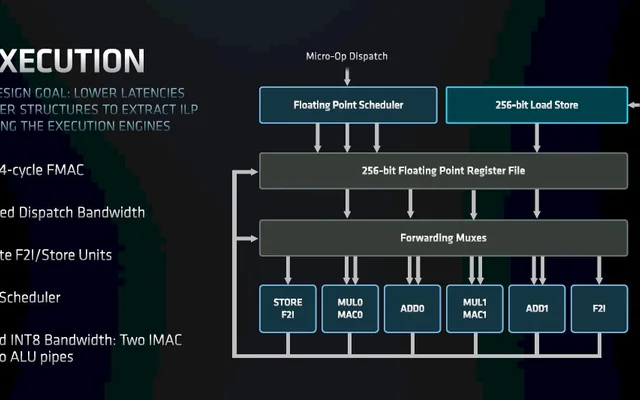
HPL 为什么是6 dispatch https://www.nextplatform.com/2021/03/26/deep-dive-into-amds-milan-epyc-7003-architecture/ https://www.nextplatform.com/wp-content/uploads/2021/03/amd-milan-epyc-zen2-versus-zen3.jpg AMD Zen4 发布会: http…
OS Assignment: Process
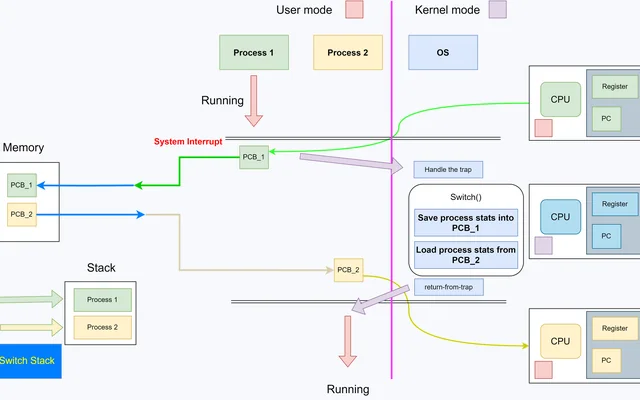
Author: Haibin Lai Student ID: 12211612 1 Three "Easy" Pieces 1.1 Three Easy pieces of Operating System: Virtualization Concurrency Persistence Explain: Virtualization means OS will make a high level abstraction on the…
Wireshark 是如何实现抓包的?
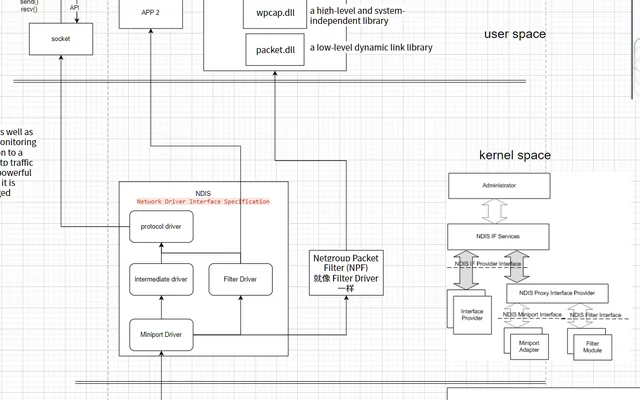
PPT: 为什么wireshark抓不到HTTP My summary web page: BPF与npcap库.drawio Wireshark 是如何实现的 wireshark的总体结构如下图所示。 【wireshark】Wireshark原理分析与二次开发系列 - 赵子清 - 博客园 (cnblogs.com) 抓包 捕获从网络适配器提取包,并将其保存到硬盘上. 访问底层网络适配器需要提升的权限,因此和底层网卡抓包的功能被封装在…
Understanding the Bias-Variance Tradeoff 解读
Webpage: Understanding the Bias-Variance Tradeoff (fortmann-roe.com) Introduction When we discuss prediction models, prediction errors can be decomposed into two main subcomponents we care about: error due to "bias" and…
为什么Rust cargo在release模式会比debug模式快很多?
为什么Rust cargo在release模式会比debug模式快很多? gpt给了一个笼统的答案,我们用矩阵乘法的例子来看看这里边的差异: debug模式中会有precondition check(图2)对程序可能的错误进行检测,这占据了其大部分运行时间,而图3 release模式下没有检查,方法栈也更少。 release模式会使用SIMD,相比图4 debug模式,图5 release模式用了intel SSE指令集中的mmx寄存…
How does OS shut down your PC?
J## 处理器:Everything is a State Machine CPU[State] 程序是在状态中循环往复 return指令的行为: 从刚刚的状态出来,然后改掉 所以:你写的程序是无法退出的。你写的程序是无法退出的。 了解windows关机过程 - 久月 - 博客园 (cnblogs.com) Linux系统自带poweroff命令,快速关闭电脑 (linux系统poweroff) – 港服(Server.HK) 纵观操…
读《咖啡机中的间谍——个人隐私的终结》
读《咖啡机中的间谍——个人隐私的终结》 拖延了好几个月之后,算是看完了这本书。对于咖啡机中的间谍,作者这里想说的,是我们的数据与隐私。我们每天早晨起床,都要冲泡一杯咖啡再去上班。那么现在有个人,他可能来自政府,也可能来自黑客组织。他通过我们信息的泄露和自己的技术,入侵了我们的咖啡机。接下来,他就可以通过咖啡机,得知每天制造咖啡的时间、次数。这些信息听起来很无聊,但我们拿他们,就可以判读你在不在家,每天几点起床,自身身体状况,进而做出更…
Google File System
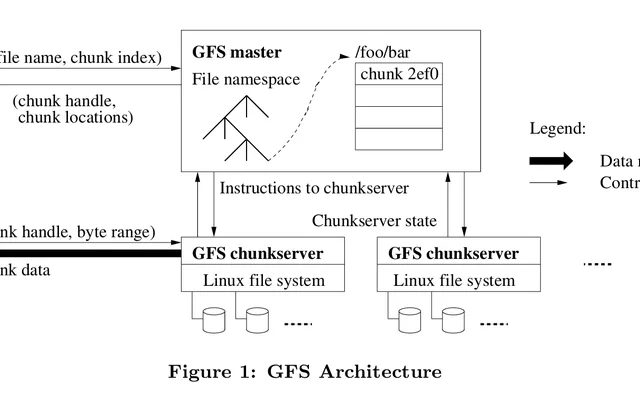
Google File System (GFS) 是 Google 为满足大规模数据存储和处理需求而设计的分布式文件系统。GFS 的设计目标是处理大量数据并提供高吞吐量的数据访问,这对于 Google 这样的公司在运行其搜索引擎和其他大规模应用时至关重要。 设立一个master可以极大的简化系统的设计,可以很方便地进行全局信息的管理。然而单一的master很容易成为系统的瓶颈,所以只能让其尽可能少的参与读写。客户端从来不从master…
Hadoop:前世今生
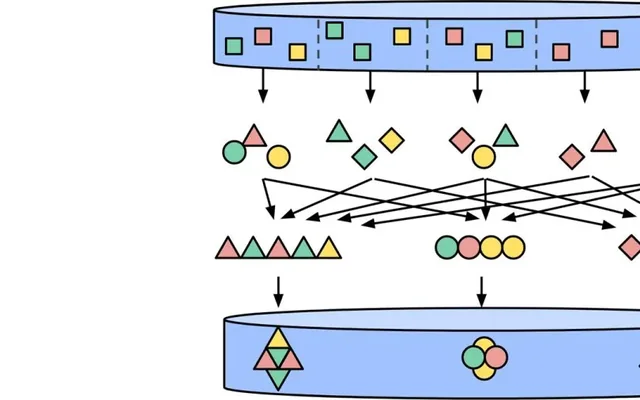
Streaming system A type of data processing engine that is designed with infinite datasets in mind. Hadoop的起源:Nutch Lucene 全文检索 1997年,Doug Cutting,后来hadoop的创始人之一,用Java写了Lucene并将其开源,目标是为各种应用软件加入全文检索功能。Lucene受到了大家的热烈追捧,大家知…
The HPL Exercise
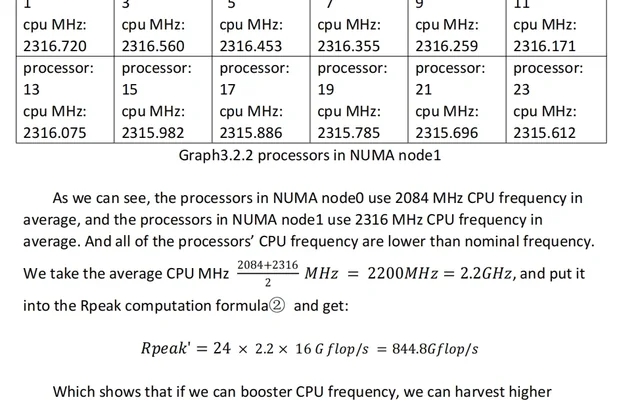
The HPL Exercise https://www.haibinlaiblog.top/wp-content/uploads/2024/09/HPL-Assignment.pdf
《生命是什么》薛定谔
本书由我的大学好朋友,Mr.Way在我的生日赠送给我,我向他承诺,一定会在生物课上阅读这本书。结果后来在飞机途中慢慢看完了。看到本书的第一眼当然是觉得奇怪,作为一个物理学家讨论生命,在近代逐渐成为一件很怪的事情。但是,薛定谔从一个物理学者的角度,对生命的遗传、生存做出了很多新奇的解释,从而推动了许多生命科学的学者对知识与真理的追求。我很震撼,沃森和克里克这两位DNA结构发现者,也收到了他的启发。 这本书首先从物理学家探讨微观事物出发…
SUSTech-CS205-CPP-Programming
SUSTech-CS205-CPP-Programming Haibin Lai 12211612 Semester: 2024 Spring; Lecturer: Prof. Shiqi Yu Project Name Description Important Point Classification Score 1 A Simple Calculator "简单"的计算器 C程序初步了解,基本数据结构的实现,数据的底层存储,内存…
CPP Project5: The beginning of Accelerated Computing
CS205·C/C++ Programming Project5 Report: The beginning of Accelerated Computing PDF 版本: Project 5 Github: https://github.com/HaibinLai/CS205-CPP-Programing-Project 摘要 “这是一个令人惊叹的时代,因为我们正处于一场新的工业革命的开始,过去蒸汽机、电力、PC和互联网带来了信息…
CPP Project4: A 2D GPU Mat
CS205·C/C++ Programming Project4 Report: A 2D GPU Mat PDF 版本: Project 4 Github: https://github.com/HaibinLai/CS205-CPP-Programing-Project 网页文档: Doxygen 摘要 本次项目的重点在于开发了一个功能强大的GPU矩阵类,该类实现了多数据输入、运算符重载、感兴趣区域(ROI)操作、内存管理以及跨G…
CPP Project3 SGEMM Optimization
CS205·C/C++ Programming Project3 Report: SGEMM Optimization PDF 版本: Project 3 Github: https://github.com/HaibinLai/CS205-CPP-Programing-Project 摘要 在本次Project里我们要优化SGEMM。我们先进行了一些理论探索,然后进行了基准测试。我们对OpenBLAS和Intel MKL进行了测试和…
CPP Project2 Matrix Multiplication
CS205·C/C++ Programming Project2 Report: Matrix Multiplication PDF 版本: Project2赖海斌 Github: https://github.com/HaibinLai/CS205-CPP-Programing-Project 摘要 同样是矩阵乘法,Java和C谁更快?在做Project之前,我会凭着经验和对于老师的信任大声告诉你答案。但是在做了本次Project后…
转载:流式计算的浪潮才刚刚开始
本文转载自《流式计算》最后一章:《大数据凉了?不,流式计算浪潮才刚刚开始》,链接为: https://www.infoq.cn/article/the-evolution-of-large-scale-data-processing 本文重点讨论了大数据系统发展的历史轨迹,行文轻松活泼,内容通俗易懂,是一篇茶余饭后用来作为大数据谈资的不严肃说明文。本文翻译自《Streaming System》最后一章《The Evolution of…
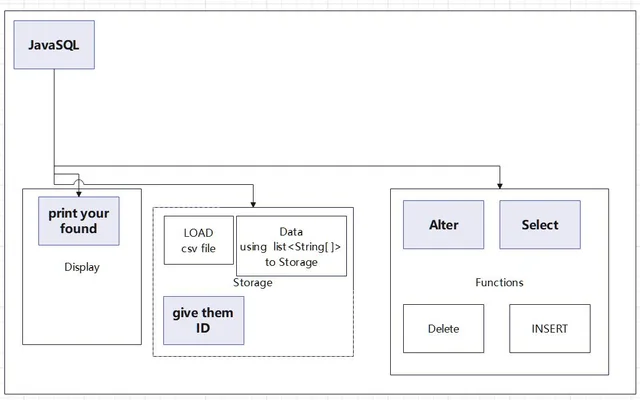
Database Project 1
https://www.haibinlaiblog.top/wp-content/uploads/2024/08/DBMS赖海斌.pdf [3d-flip-book id="174" ][/3d-flip-book]
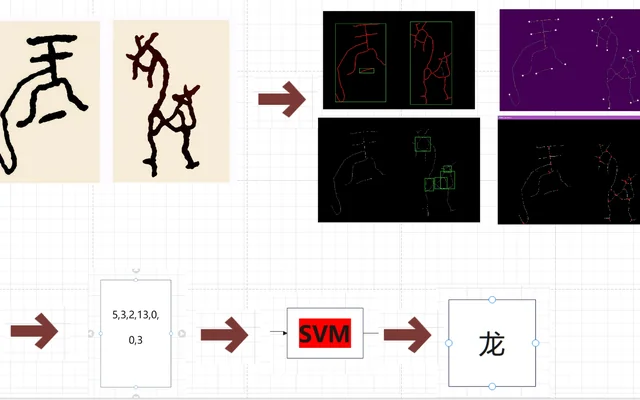
Graph Based Method for Oracle Bone Inscriptions Recognition
https://www.haibinlaiblog.top/wp-content/uploads/2024/08/Graph_Based_Method_for_Oracle_Bone_Inscriptions_Recognition.pdf [3d-flip-book id="189"][/3d-flip-book] https://www.haibinlaiblog.top/wp-content/uploads/2024/08/Gr…
CPP Project1 A “Simple” Calculator
CS205 · C/C++ Programming Project1 Report: A "Simple" Calculator PDF 版本: Project1赖海斌 Github: https://github.com/HaibinLai/CS205-CPP-Programing-Project 摘要 在本次 Project 中,我初步用C 实现了一个简单的计算器,可以简单地完成项目需求。 在计算器的输入有效数字小于 8 位时,我…
Data Stream Mining
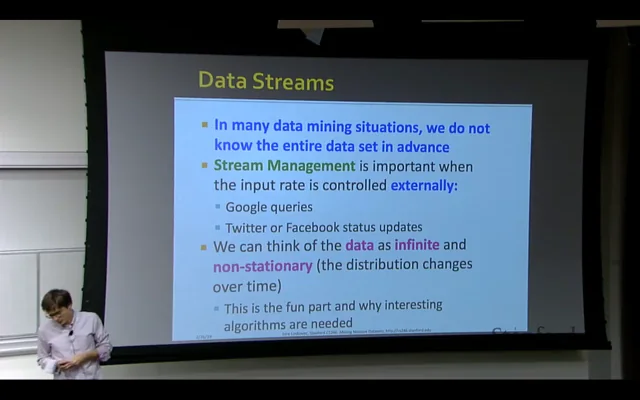
Stream Data is becoming more and more important SGD as an example Problems: Sampling data from a stream Queries over sliding windows APP Question1:Sampling
Docker run Geochem Pi
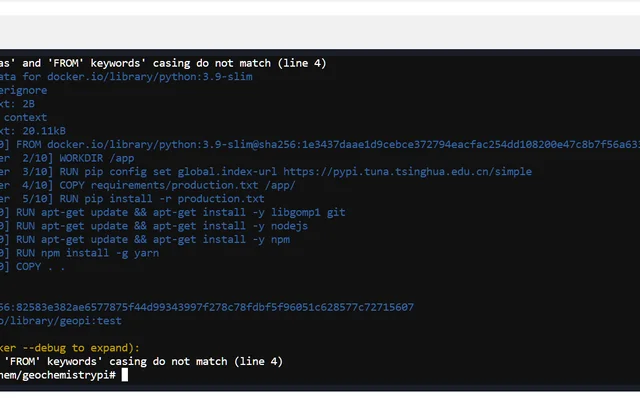
安装 pip本地镜像问题 apt-get本地镜像问题 部署 部署后端可以选择自动部署 yarn没有安装: yarn install 5173而非3001 启动时为 --host暴露端口 使用版本: 华为云 端口暴露 宝塔Linux ssl证书、Docker管理
Hungarian Algorithm
Hungarian Algorithm Algorithm Design and Analysis (H) Assignment 5 Name: 赖海斌 SID: 12211612 Abstract In this assignment we try to analyze Hungarian algorithm. It’s an efficient algorithm for solving the min-cost max-matc…
人月神话 读书笔记
介绍:本篇为《人月神话》的读书笔记和记录。读书时还参考了别的博主的总结及相关介绍。 人月神话 001 焦油坑 过去几十年的大型系统开发就犹如一个焦油坑,很多大型动物在其中剧烈挣扎,他们中大多数开发出了可运行的系统--不过,其中只有非常少数的项目满足了目标、时间进度和预算的要求。 各种团队,大型的和小型的,庞杂的和精干的,一个接一个淹没在了焦油坑中。表面上看起来好像没有任何一个单独的问题会导致困难,每个都能被解决,但是当它们相互纠缠和累…
我们在高中和大学遇到的题目是一样的吗
这篇文章算是自己一年学习的小感悟,也是想给刚入大学的同学们一点思考。 大学一年,学习到很多新知识,新概念,这里边碰到了很多新问题,新题目。在高中,问题的核心,是抓定义,抓套路。但是,大学里边的问题,更多的是探索定义,探索证明。这里边要求我们转变问题思维。 在高中,我们都是做题高手,接受了大量题目的练习后,我们遇到卷子可以拿笔就写,遇到问题直接开动。我常笑我们是做题机器,试卷就是输入,看到第一题立马调用程序,2个小时后输出程序结果,检查…
离散数学及其应用 有趣的问题
就像写程序一样,我的定理被不断重构,不断升级,最后变成了一座山峰。 第一章 基础:逻辑和证明 比较好的地方在于讨论了很多证明,这些是智力小游戏。比较快乐的是骑士骗子与平民游戏。 1.试讨论逻辑悖论,包括克里特人Epimenides悖论,Jourdain的纸牌悖论,理发师悖论。 2.模糊逻辑是什么?怎样用于实际应用? 3.实际问题中可满足性问题的建模。 4.不必借助计算机解决数独谜题的技巧。 5.由Layman Allen提出的“WFF…
在路上 读书笔记
“Live, travel, adventure, bless, and don’t be worry.” “我一辈子都喜欢跟着让我感觉有兴趣的人,因为在我心目中,真正的人都是疯疯癫癫的,他们热爱生活、爱聊天,不露锋芒希望拥有一切,他们从不疲倦,从不讲那些平凡的东西。” 当我第一次看到这句话时,我感受到着实的震撼,在此之前,从来没有人能如此准确说出心中的梦想。在我的生命中,我一直讨厌那些乖乖仔,因为他们似乎通过展现自己,从而得到别人的…
系统综合设计 智能电池小车 Final Report
作者 :赖海斌 覃仁杰 陈沛安 摘要 在本次SDIM101课程中,我们小组制作了一辆碳纤维锌电池寻轨小车。小车整体结构采用拱形构造,设计上分为多层,上层将压力点化为面,中层电池采用三并两串的接线为小车提供动力,下层主板驱动小车巡线。小组采用预浸料+真空袋的方式制作小车车身,底板上装配电池组,控制上采用PID算法进行巡线。在制作中,我们采用仿真+实验的方式改善小车在巡线与三点弯测试中的效果,并最终在巡线测试中10分钟内完成27圈,在三点…
No writing matches this filter.