 Haibin's blog
Academic
SMEPilot: Characterizing and Optimizing LLM Inference with Scalable Matrix Extensions
来自IPADS的文章。这篇文章把ARM里的矩阵加速器SME用在CPU LLM Serving上。SME是ARM提出的一个加速装置,功能类似Intel的AMX加速器(AMX类似GPU里的TensorCore) Modern CPUs increasingly integrate matrix extensions, such as Arm Scalable Matrix Extension (SME) ARM的SME跟Intel里AMX…
来自IPADS的文章。这篇文章把ARM里的矩阵加速器SME用在CPU LLM Serving上。SME是ARM提出的一个加速装置,功能类似Intel的AMX加速器(AMX类似GPU里的TensorCore)
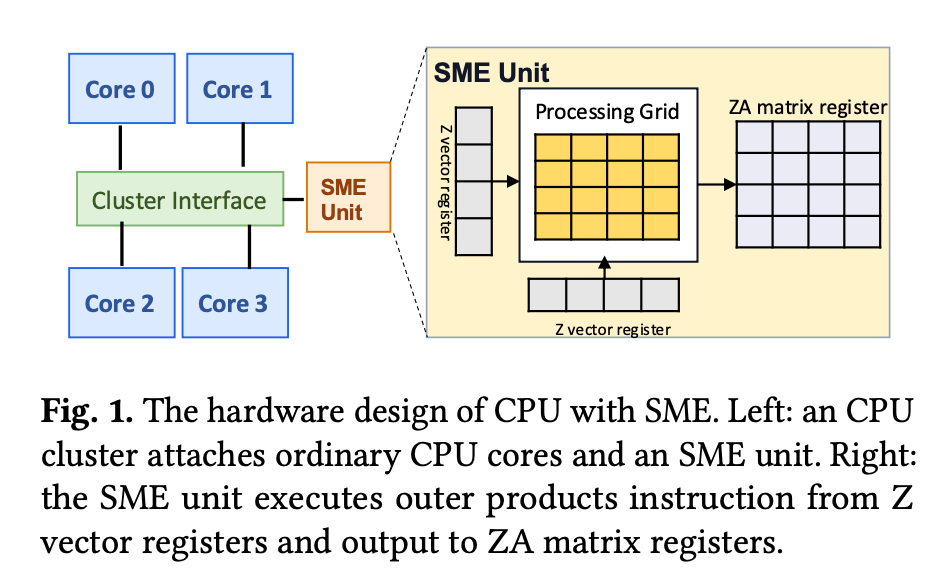
Modern CPUs increasingly integrate matrix extensions, such as Arm Scalable Matrix Extension (SME)
ARM的SME跟Intel里AMX最大的区别是,SME是跟计算core分离的,他们共享内存带宽,但是不共享L1 L2 Cache。
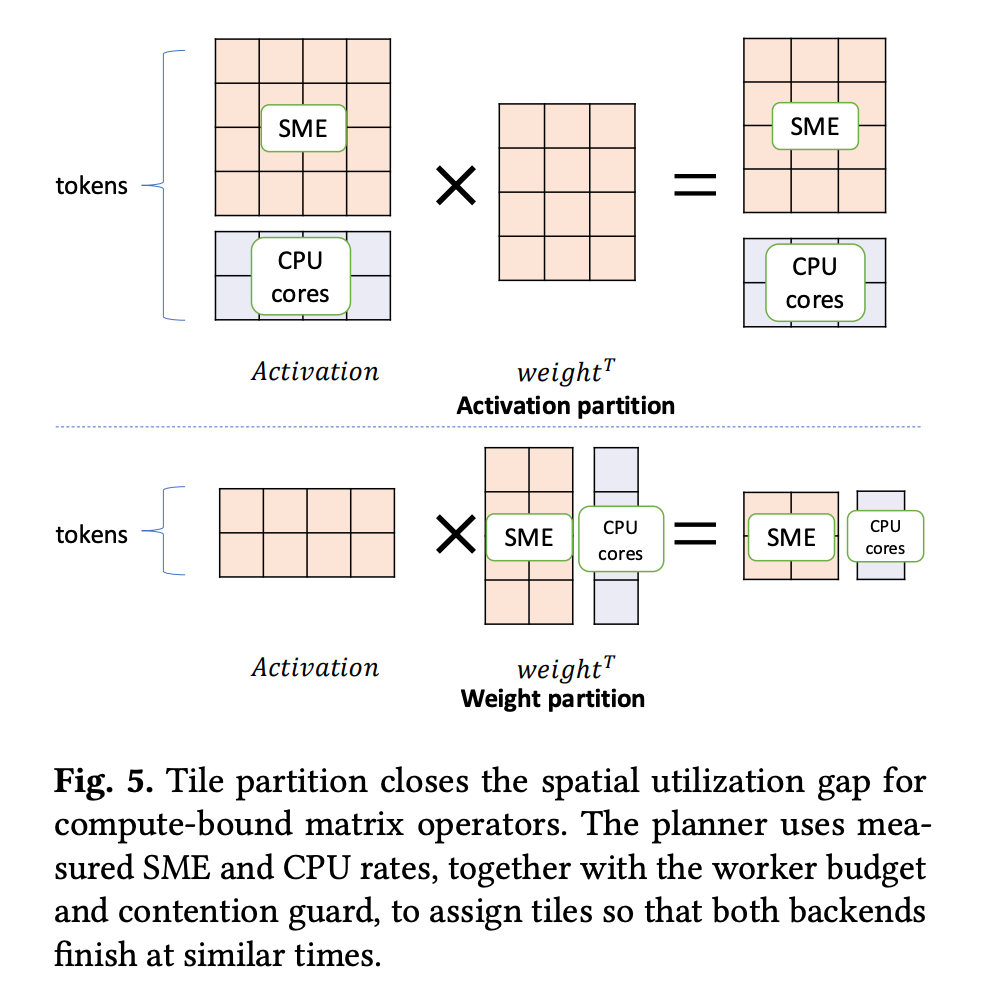
看知乎里也有讨论过SME的得失。比较大的问题是,由于SME是单独分离的,有时候一旦core数量多起来,多核的优势会大于单开SME的优势。SME不是一个scalable的东西。这也是这篇文章的核心想法:在计算时,矩阵的一部分计算给SME,一部分给传统Core,大家一起协同计算。(下图里的Mixed)
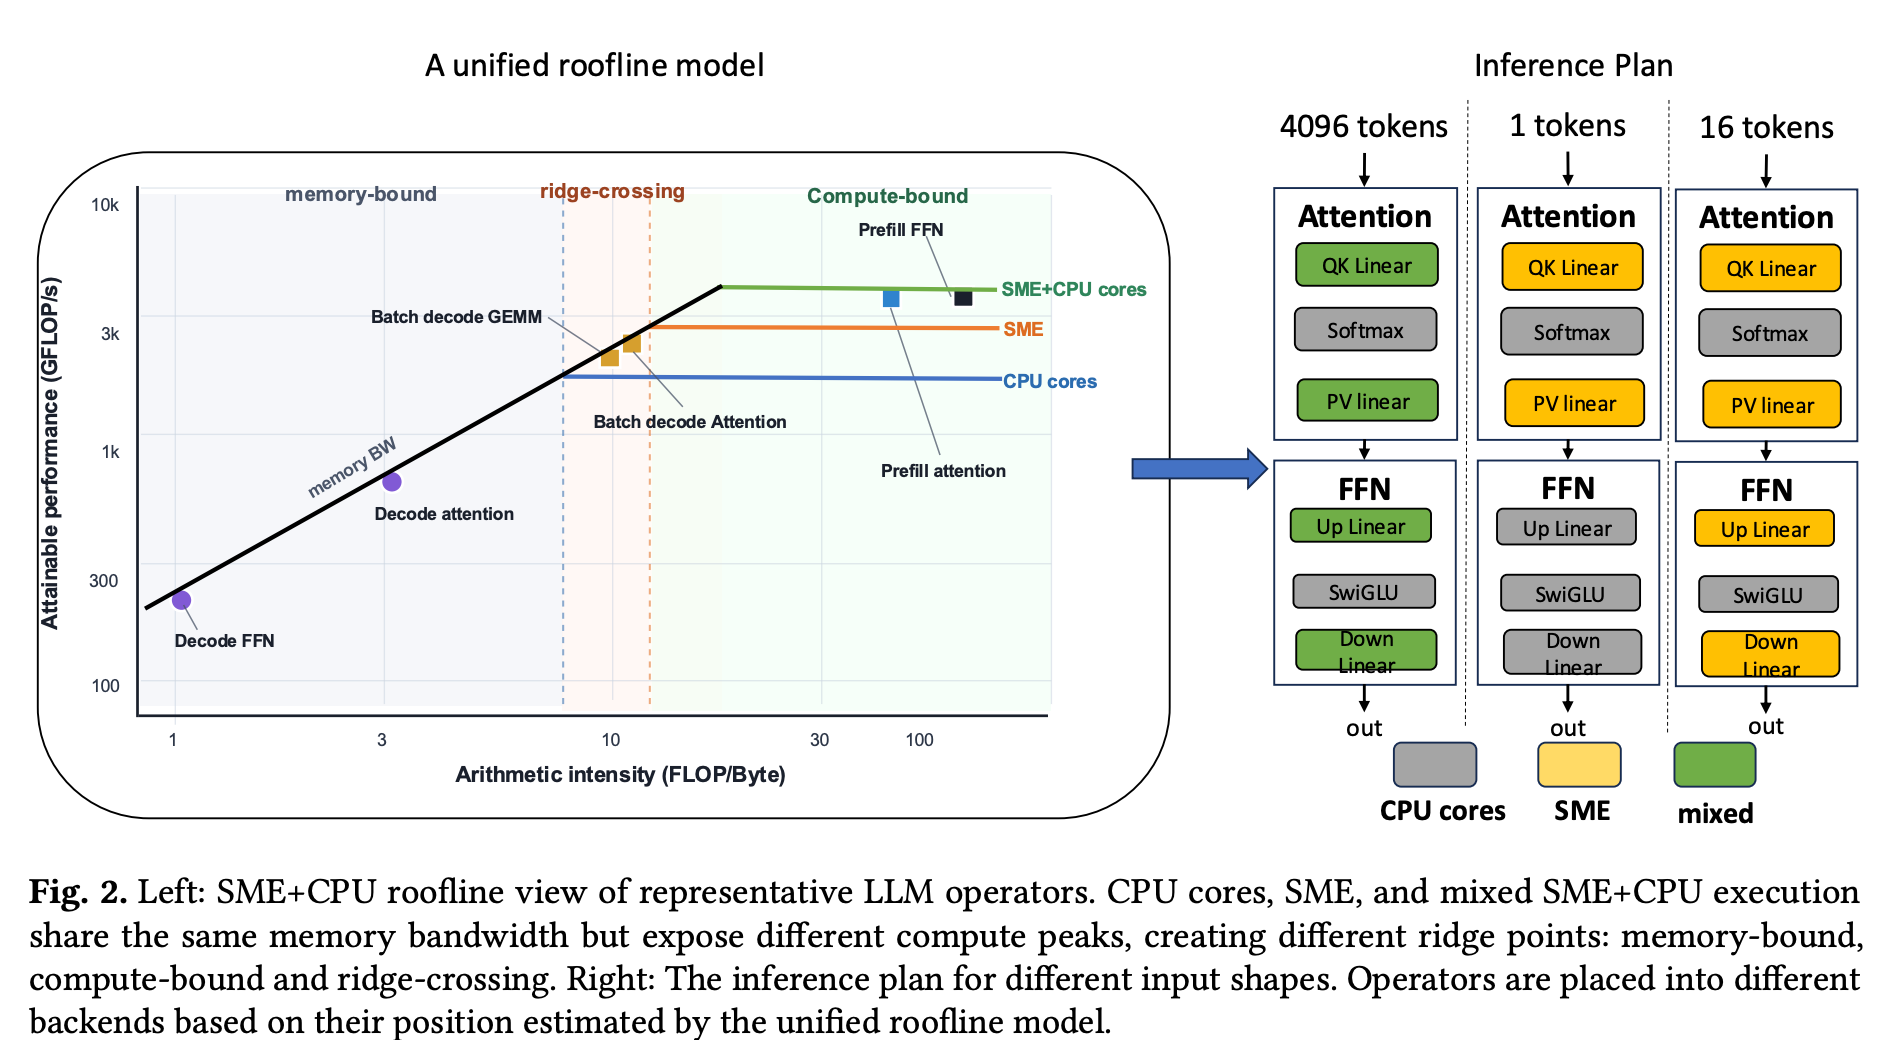
这样的动态调配,有一个比较大的问题,就是要慢慢调。超参数很多,稍微行数变一下,kernel的时间、缓存、machinebalance等就变了。猜测这里作者调了不少时间。
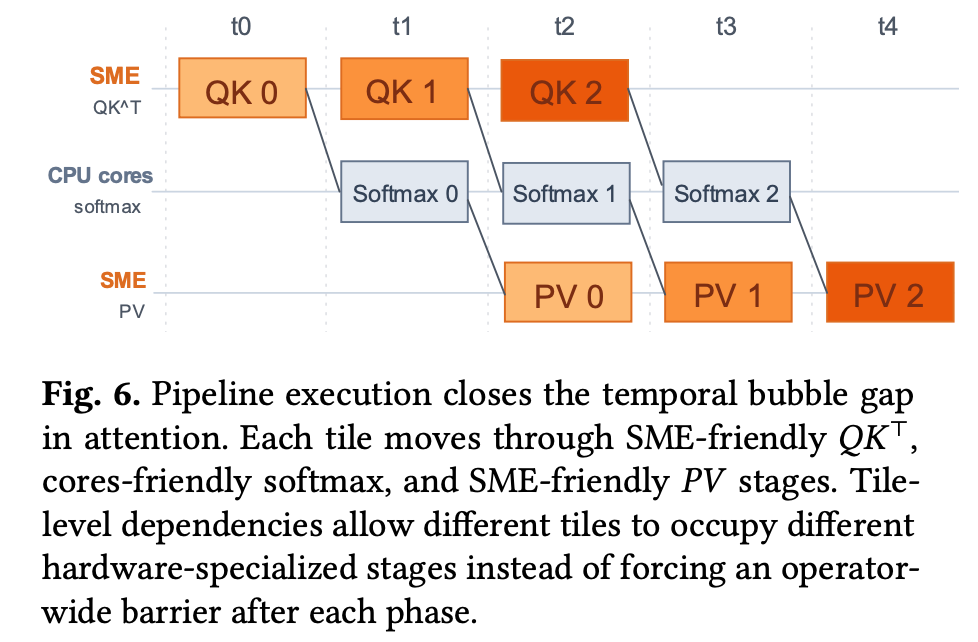
Pipeline这里估计调的更狠,并且怀疑这里的效果。虽然消融实验显示降低了一倍,但是,这里QK、PV的大小一变,pipeline的效果有可能就不明显了,用在实际工程里可能比较难用,毕竟你的请求大小是会动态变的,我们没有那么多时间像文章里的profiler等等,用在生产里。只能说要调的好了。
但是总体来说,写作和思路都还是挺不错的,文章还是值得一读的。至少能给codex看看。 https://arxiv.org/pdf/2606.16332 但是没开源,,
这里作者还给了一个ARM的microkernel库,值得看和抄。 https://github.com/ARM-software/kleidiai
If you need to cite this post
Haibin Lai. (August 30, 2026). “SMEPilot: Characterizing and Optimizing LLM Inference with Scalable Matrix Extensions” [Blog post]. Retrieved from https://www.haibinlaiblog.top/posts/smepilot-characterizing-and-optimizing-llm-inference-with-scalable-matrix-extensions/
@online{lai-smepilot-characterizing-and-optimizing-llm-inference-with-scalable-matrix-extensions,
  title={SMEPilot: Characterizing and Optimizing LLM Inference with Scalable Matrix Extensions},
  author={Haibin Lai},
  year={2026},
  url={https://www.haibinlaiblog.top/posts/smepilot-characterizing-and-optimizing-llm-inference-with-scalable-matrix-extensions/},
}