 Haibin's blog
Paper Reading
为什么高维非凸优化没有被局部极小值困住?
为什么高维非凸优化没有被局部极小值困住?
本文主要回顾两篇 2014–2015 年的论文:
- Dauphin et al., Identifying and attacking the saddle point problem in high-dimensional non-convex optimization(NeurIPS 2014)
- Choromanska et al., The Loss Surfaces of Multilayer Networks(AISTATS 2015)
局部最优需要”所有方向都向上弯”
看最近漫士的二次型视频( https://www.youtube.com/watch?v=XUc4nMQsXTI ),我们知道,在一个临界点处,如果我们看 Hessian 矩阵的特征值:
- 局部极小值:所有 d 个特征值都 > 0
- 鞍点:有正有负
- 局部极大值:全部 < 0
如果粗略假设每个方向”向上弯”或”向下弯”的概率各为 1/2、彼此独立,那么 d 个方向全部向上的概率约为 (1/2)^d。当d很大时,这个概率几乎为零。所以高维里的临界点绝大多数是鞍点(The prevalence of saddle points in high dimensions, prevalence这个词用的好):总有某些方向还能继续下降,优化器就有路可走。
那么,平时困住我们优化器的到底是什么?
NIPS14 极小值不是问题,鞍点才是
在Dauphin et al. NIPS2014( https://arxiv.org/pdf/1406.2572 )讲了这样的故事:我们经常用2D平面来可视化优化器搜索最优损失的过程,并且在这过程中,自然而然地看到搜索很容易进入极小值。但是,这篇文章里,作者基于统计物理、随机矩阵理论、神经网络理论以及经验证据提出:一个更深层、更根本的困难来自鞍点的大量存在,而不是局部极小值,在有实际意义的高维问题中尤其如此。(a deeper and more profound difficulty originates from the proliferation of saddle points, not local minima, especially in high dimensional problems of practical interest.)这些鞍点被高误差的平台包围,平台会大幅拖慢学习,并造成存在局部极小值的假象。
Intro
对于 N 个标量变量(即 N 维)的典型随机高斯误差函数,随着 N 增大,函数越来越可能具有鞍点而不是局部极小值。实际上,鞍点数量与局部极小值数量之比随维度 N 呈指数增长。
局部极小值和鞍点的一个典型问题是:它们周围常常是误差曲率很小的平台。梯度下降的动力学会沿负曲率方向被推离鞍点、走向更低的误差,但由于平台的存在,这种推离可能很慢。二阶方法(如牛顿法)的设计目标,是通过用 Hessian 矩阵特征值的倒数重新缩放梯度步长,快速地走下局部极小值周围的平台。然而,牛顿法不能恰当地处理鞍点;正如下文所论证的,在牛顿动力学下,鞍点反而变成吸引子。
因此,鉴于高维问题中大量存在的是鞍点而不是局部极小值,拟牛顿方法的全部理论依据(即快速下降到凸的局部极小值底部的能力)在高维非凸优化中变得不那么相关了。
文章回顾了来自不同文献的论证,它们表明:阻碍高维非凸优化快速进行的根本障碍是鞍点,而不是局部极小值。
统计物理的证据
一条证据来自统计物理。Bray and Dean (2007) 与 Fyodorov and Williams (2007) 用复本理论(replica theory)研究了高维连续域上随机高斯误差函数的临界点性质(该方法的近期综述见 Parisi (2007))。
Bray and Dean (2007) 的一个具体结果,推导了临界点在 ε–α 平面上的分布。其中 α 是指数(index),即临界点处 Hessian 负特征值的占比;ε 是该临界点处的误差。在这个平面内,当 α 从 0 变到 1 时,临界点集中在一条单调递增的曲线上。这意味着误差 ε 与指数 α 之间存在很强的相关性:误差越大,指数越大。
对于大的 N,临界点偏离这条曲线 O(1) 距离的概率,随维度 N 呈指数级小。这意味着:误差 ε 远大于全局最小值误差的临界点,以指数级的可能性是鞍点,其负曲率方向的比例是误差的增函数。反过来,所有局部极小值(它们必然指数为 0)的误差很可能非常接近全局最小值的误差。
直观上,在高维空间里,一个临界点周围所有方向都向上(正曲率)的概率,关于维度数是指数级小的,除非这个临界点就是全局最小值,或者其误差水平接近全局最小值,也就是说,已经不太可能找到继续往下走的路了。
随机矩阵理论的视角
这些结果也可以用随机矩阵理论来理解。我们知道,对于大的高斯随机矩阵,其特征值分布服从 Wigner 著名的半圆律(Wigner, 1958),众数和均值都在 0。因此一个特征值为正或为负的概率都是 1/2。
Bray and Dean (2007) 证明,临界点处 Hessian 的特征值分布与此相同,区别只是半圆形的谱被平移了一个由 ε 决定的量。对于全局最小值,谱被平移到很靠右的位置,使得所有特征值都为正。随着 ε 增大,谱向左移动,出现越来越多的负特征值,同时在 0 附近也聚集出一定的特征值密度。这表明在误差较大时,鞍点周围通常存在平台。
这样的平台会拖慢一阶优化方法的收敛,造成存在局部极小值的假象。随机矩阵的视角还简明而直观地突出了低维与高维误差曲面几何性质的鲜明差异。当 N = 1 时,恰好是鞍点是一个概率为 0 的事件,因为这意味着随机取到的特征值恰好为 0。随着 N 增大,随机取到的特征值全部为正(或全部为负)的概率变得指数级小,因此大多数临界点是鞍点。
Fyodorov and Williams (2007) 回顾了在二次误差曲面上叠加随机误差函数的情形下得到的定性类似的结果。这些工作表明:对于从随机高斯函数族中选取的典型、一般函数,高误差的局部极小值在问题维度上是指数级稀少的,而具有许多负曲率方向和近似平台方向的鞍点则以指数级的可能性出现。
总结
作者引用统计物理里对高斯随机场临界点的研究(Bray & Dean 等人的工作)。核心结论可以概括为:
- 定义临界点的 index 为 Hessian 负特征值的占比。
- 对于高维随机函数,临界点的损失值与 index 强相关:
- 损失高 → 负特征值占比高(接近”最大值”的鞍点);
- 损失低 → 负特征值占比趋近 0(接近极小值)。
- 因此局部极小值集中在低损失区域,高损失区域几乎全是鞍点。
有研究也分析了实际关心的问题的误差曲面,结果和上述对特别网络的分析类似。
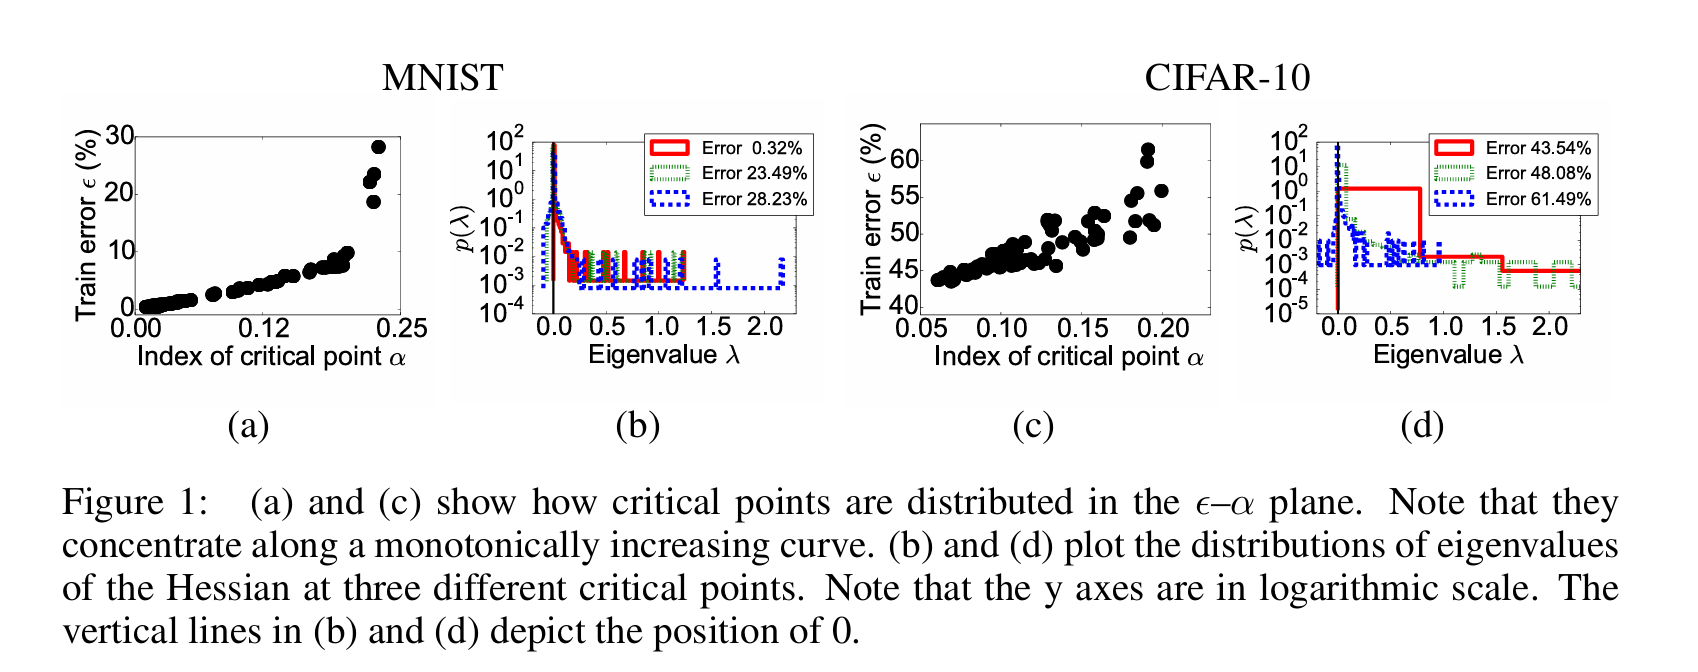 Dauphin et al. 论文的 Figure 1,用 MNIST和 CIFAR-10数据集在真实的小型网络上验证”损失越高,负特征值越多”。
不同优化算法在鞍点附近的行为
鉴于鞍点的普遍性,理解各种优化算法在鞍点附近的行为就很重要。我们聚焦于 Hessian 非奇异的非退化鞍点。这类临界点可以按照 Morse 引理(见 Callahan (2010) 第 7.3 章定理 7.16,或附录 B)重新参数化,从而做局部分析:
其中 λᵢ 是第 i 个 Hessian 特征值,Δvᵢ 是模型的新参数,对应于沿 f 在 θ* 处 Hessian 的特征向量 eᵢ 的运动。
梯度下降
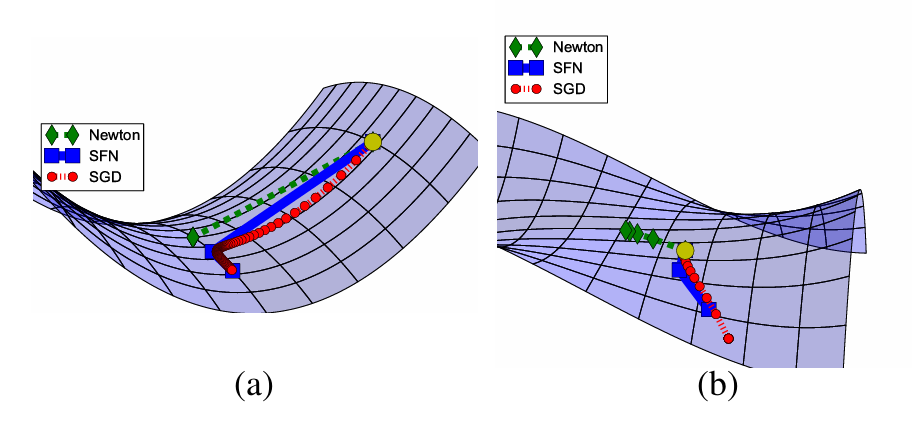
在鞍点附近,梯度下降的一步方向总是对的(图 2 中的 SGD)。如果特征值 λᵢ 为正(负),那么这一步沿 Δvᵢ 朝向(远离)θ*,因为 f 限制在对应特征向量方向 Δvᵢ 上时,在 θ* 处取极小(极大)值。
梯度下降的缺点不在方向,而在沿每个特征向量的步长。沿任一方向 eᵢ 的步长是 −λᵢΔvᵢ,所以在绝对值很小的特征值对应的方向上,步子会很小。
牛顿法
牛顿法通过用对应特征值的倒数缩放各方向的梯度,解决了慢的问题,得到步长 −Δvᵢ。然而,这种做法可能让你朝错误的方向走。具体来说,如果某个特征值为负,牛顿步沿特征向量的方向与梯度下降步相反,因此朝着 θ* 移动,误差在增加。由于它在特征值为正的特征方向上同样朝 θ* 移动,鞍点 θ* 就成了牛顿法的吸引子(见图 2)。这也说明了为何在图 1 中可以用牛顿法来找任意指数的临界点。
图 2: 不同优化方法在鞍点附近的行为:(a) 经典鞍点结构 5x² − y²;(b) 猴鞍结构 x³ − 3xy²。黄点表示起点。SFN 表示我们提出的无鞍点牛顿法。(图中比较 Newton、SFN、SGD 三条轨迹。)
信赖域与阻尼牛顿法
信赖域方法是非凸问题二阶方法的一种实用实现。在其中一种方法里,通过在 Hessian 对角线上加一个常数 α 来阻尼,从而去掉负曲率,这等价于给每个特征值加上 α。用修改后的特征值 λᵢ+α 的倒数缩放梯度,得到步长 −λᵢ/(λᵢ+α) Δvᵢ。
为确保沿每个特征方向都下降,必须把阻尼系数 α 增加到足够大,使得即使对最负的特征值 λ_min 也有 λ_min + α > 0。因此缺点同样是:大的阻尼因子会使许多特征方向上的步长可能很小。
忽略负曲率
除阻尼外,另一种处理负曲率的方式是忽略它们。无论牛顿法使用什么近似策略,如截断牛顿法或 BFGS 近似(见 Nocedal and Wright (2006) 第 4 章和第 7 章),都可以这样做。然而,这类算法无法逃离鞍点,因为它们忽略了逃离所必须沿着走的负曲率方向。
自然梯度下降
自然梯度下降是一种依赖参数流形曲率的一阶方法 Natural gradient descent is a first order method that relies on the curvature of the parameter manifold。也就是说,自然梯度下降所走的一步,会使模型行为(用步前与步后模型之间的 KL 散度衡量)产生恒定的变化。得到的算法与牛顿法类似,只是它依赖的是 Fisher 信息矩阵 F。Rattray et al. (1998)、Inoue et al. (2003) 论证了自然梯度下降能有效处理某些鞍点结构。具体而言,它能解决那些由单元行为过于相似而产生的鞍点。
然而 Mizutani and Dreyfus (2010) 指出,自然梯度下降同样受负曲率困扰。一个已知的问题是过可实现区域:在平稳解 θ* 周围,Fisher 矩阵是秩亏的。数值上,这意味着在距 θ* 较远的某点,Gauss-Newton 方向可能与梯度正交,使优化收敛到某个非平稳点。另一个弱点是:在某些表现出强负曲率的鞍点附近,Hessian 与 Fisher 信息矩阵之差 S 可能很大。这意味着这些临界点附近的地形可能由 S 主导,于是 F⁻¹ 提供的缩放并非在所有方向上都最优。TONGA(Le Roux et al., 2007)是一种与自然梯度下降类似的算法,同样如此。它使用梯度的协方差作为缩放因子。由于接近临界点时这些梯度趋于消失,它们的协方差会导致在临界点附近的步长远大于所需。
| 方法 | 方向保持 | 平坦方向放大 | 依据的信息 | 需要 Hessian |
|---|---|---|---|---|
| SGD | 是 | 否 | 梯度 | 否 |
| 牛顿法 | 否(负曲率) | 是 | 曲率 | 是 |
| SFN | 是 | 是 | 曲率的绝对值 | 是(近似) |
| AdamW | 是 | 部分(按梯度幅度) | 梯度统计 | 否 |
| Muon | 是 | 部分(按奇异值) | 梯度矩阵结构 | 否 |
Adam 类方法有专门的鞍点分析。 Staib et al. (ICML 2019) 论证:RMSProp、Adam 这类预条件方法,会让鞍点附近的梯度噪声在各方向上大致相等,因此比 SGD 更快逃离鞍点。Muon 也有人专门分析, 2026 年 5 月 Dimension-Free Saddle-Point Escape in Muon,声称 Muon 的逃离时间不随维度增长,而逐元素的自适应方法(如 AdamW)有这个问题。
作者提出的SFN
作者从牛顿法出发,提出一个鞍部改良优化器,把 Hessian 换成”特征值取绝对值”的 |H|。
牛顿法:
SFN:
也就是对 H 做特征分解后,保持特征向量不变,只把每个特征值 λᵢ 换成 |λᵢ|。
| 曲率 | 牛顿法 | SFN |
|---|---|---|
| λ > 0(碗) | 一步到底 | 一步到底(与牛顿法相同) |
| λ < 0(帽子) | 走向鞍点,方向错 | 远离鞍点,方向对 |
- 牛顿法除以 λ,负的 λ 把下降方向翻过来了,所以鞍点成了它的吸引子。
- SFN 除以 |λ|,大小的归一化保留,符号不翻转。
- 当 Hessian 正定时,|H| = H,SFN 与牛顿法完全一致。
在高维下的近似: 在高维度下,完整的 Hessian 太大了,论文用 Lanczos 迭代找 Hessian 最大的 k 个特征方向 V,把参数写成 θ + Vα,只在这个 k 维子空间里精确做 SFN。不过总之,计算的代价还是挺大。
要求:待最小化的函数 f(θ)
for i = 1 → M do
    V ← ∂²f/∂θ² 的 k 个 Lanczos 向量
    f̂(α) ← f(θ + Vα)
    |Ĥ| ← ∂²f̂/∂α²,通过对 Ĥ 做特征分解得到绝对值
    for j = 1 → m do
        g ← −∂f̂/∂α
        λ ← argmin_λ f̂( g (|Ĥ| + λI)⁻¹ )
        θ ← θ + g (|Ĥ| + λI)⁻¹ V
    end for
end for
效果
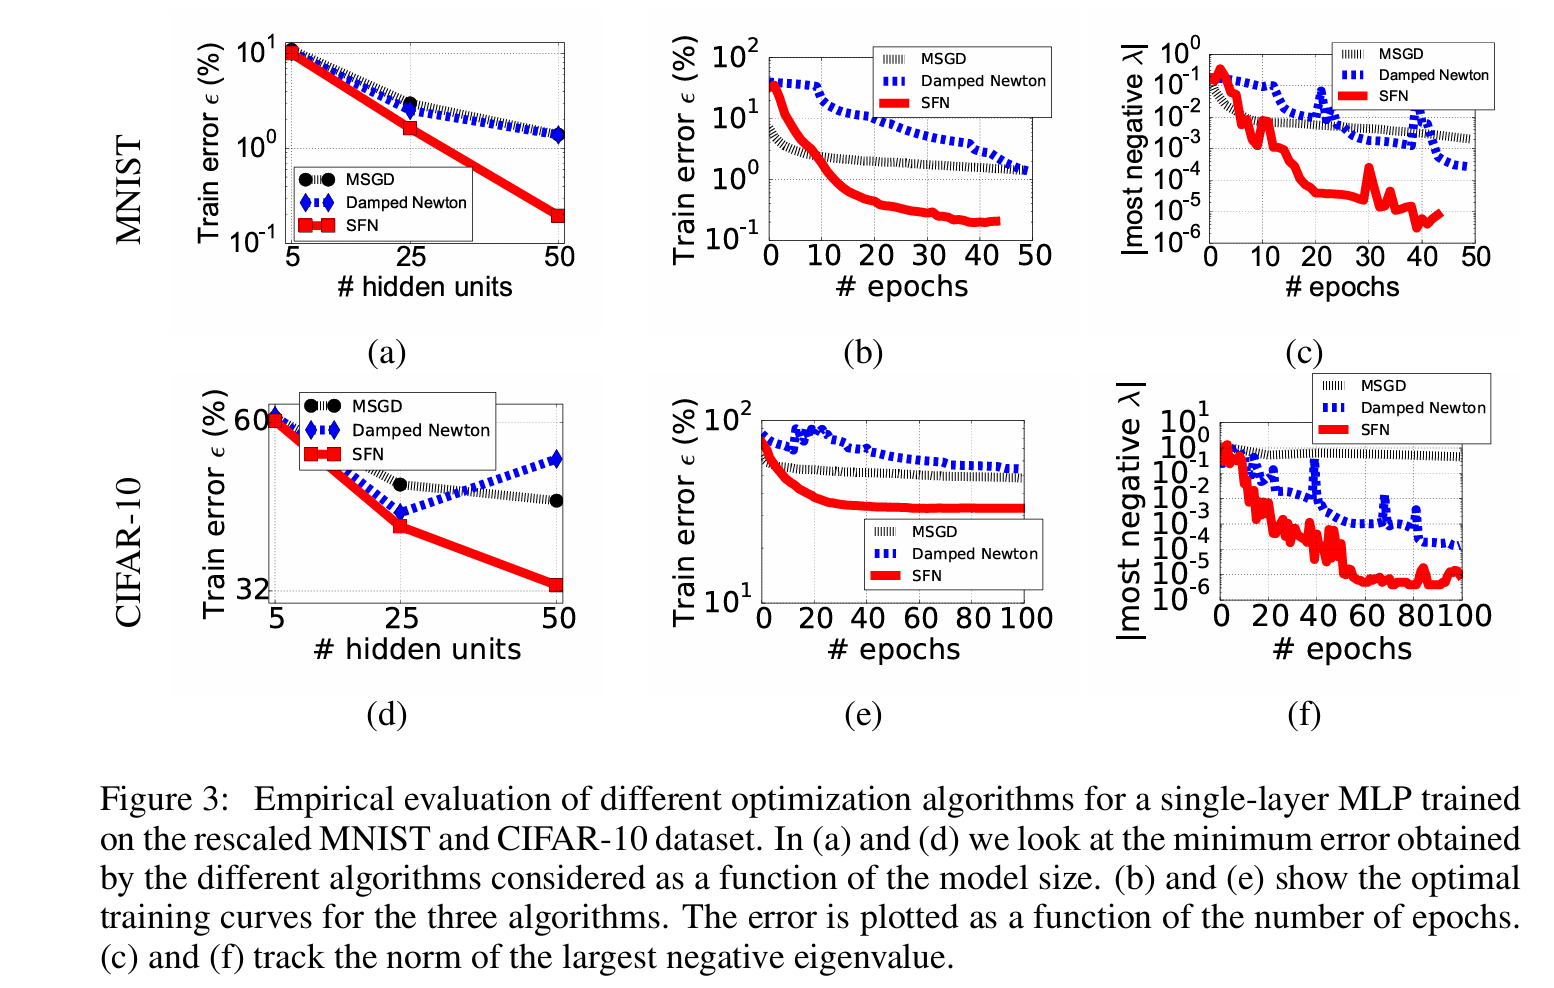
极小值的质量都很接近
Choromanska et al. (2015) ( https://arxiv.org/pdf/1412.0233 )把带 ReLU 的 L 层网络的输出写成路径之和:每条从输入到输出的路径,贡献一个权重乘积。在一组假设下,损失函数可以写成与球形自旋玻璃哈密顿量同形的表达式。经过一堆推导,最后得出结论:
- 临界点按损失值分层。 在大尺寸极限下,低 index 的临界点(接近极小值)集中在一个窄的损失带里;这个带之上是大量高 index 的鞍点。
- 带的下沿是”全局最小”所在。 随着网络变大,局部极小值的损失值都挤在这个下沿附近,彼此差距缩小。
- 深度的影响。 层数 L 增大时,这个带更窄,局部极小值更集中;找到真正的全局最小值变得更难,但对泛化而言,我们本来也不需要它。
- 全局最小值未必是好事。 作者认为,追求训练集上的全局最小,更可能导致过拟合。
If you need to cite this post
Haibin Lai. (November 21, 2026). “为什么高维非凸优化没有被局部极小值困住?” [Blog post]. Retrieved from https://www.haibinlaiblog.top/posts/wei-shen-me-gao-wei-fei-tu-you-hua-mei-you-bei-ju-bu-ji-xiao-zhi-kun-zhu/
@online{lai-wei-shen-me-gao-wei-fei-tu-you-hua-mei-you-bei-ju-bu-ji-xiao-zhi-kun-zhu,
  title={为什么高维非凸优化没有被局部极小值困住?},
  author={Haibin Lai},
  year={2026},
  url={https://www.haibinlaiblog.top/posts/wei-shen-me-gao-wei-fei-tu-you-hua-mei-you-bei-ju-bu-ji-xiao-zhi-kun-zhu/},
}
DISCUSSION
Comments
No imported comments yet. Start the conversation below.
Leave a comment with GitHub