 Haibin's blog
Paper Reading
ICLR26 LLMs Get Lost In Multi-Turn Conversation
在Agent领域的一篇很著名的研究。文章的核心是We find that LLMs often make assumptions in early turns and prematurely attempt to generate final solutions, on which they overly rely. In simpler terms, we discover that when LLMs take a wrong turn in a conversation, they get lost and do not recover.
The Paper is from MSR and Salesforce research
在Agent领域的一篇很著名的研究。文章的核心是:We find that LLMs often make assumptions in early turns and prematurely attempt to generate final solutions, on which they overly rely. In simpler terms, we discover that when LLMs take a wrong turn in a conversation, they get lost and do not recover. 也就是说,LLM在多轮对话后,就更容易失败。
文章链接: https://arxiv.org/pdf/2505.06120
这篇文章是ICLR26 best paper https://www.microsoft.com/en-us/research/publication/llms-get-lost-in-multi-turn-conversation/
Main Idea
文章的首图已经很好地解释了测试的内容。同样3个要求,一次一次发还是一起发,性能就会出现下降。大概原因就是LLMs可能会走错然后就不回来了。
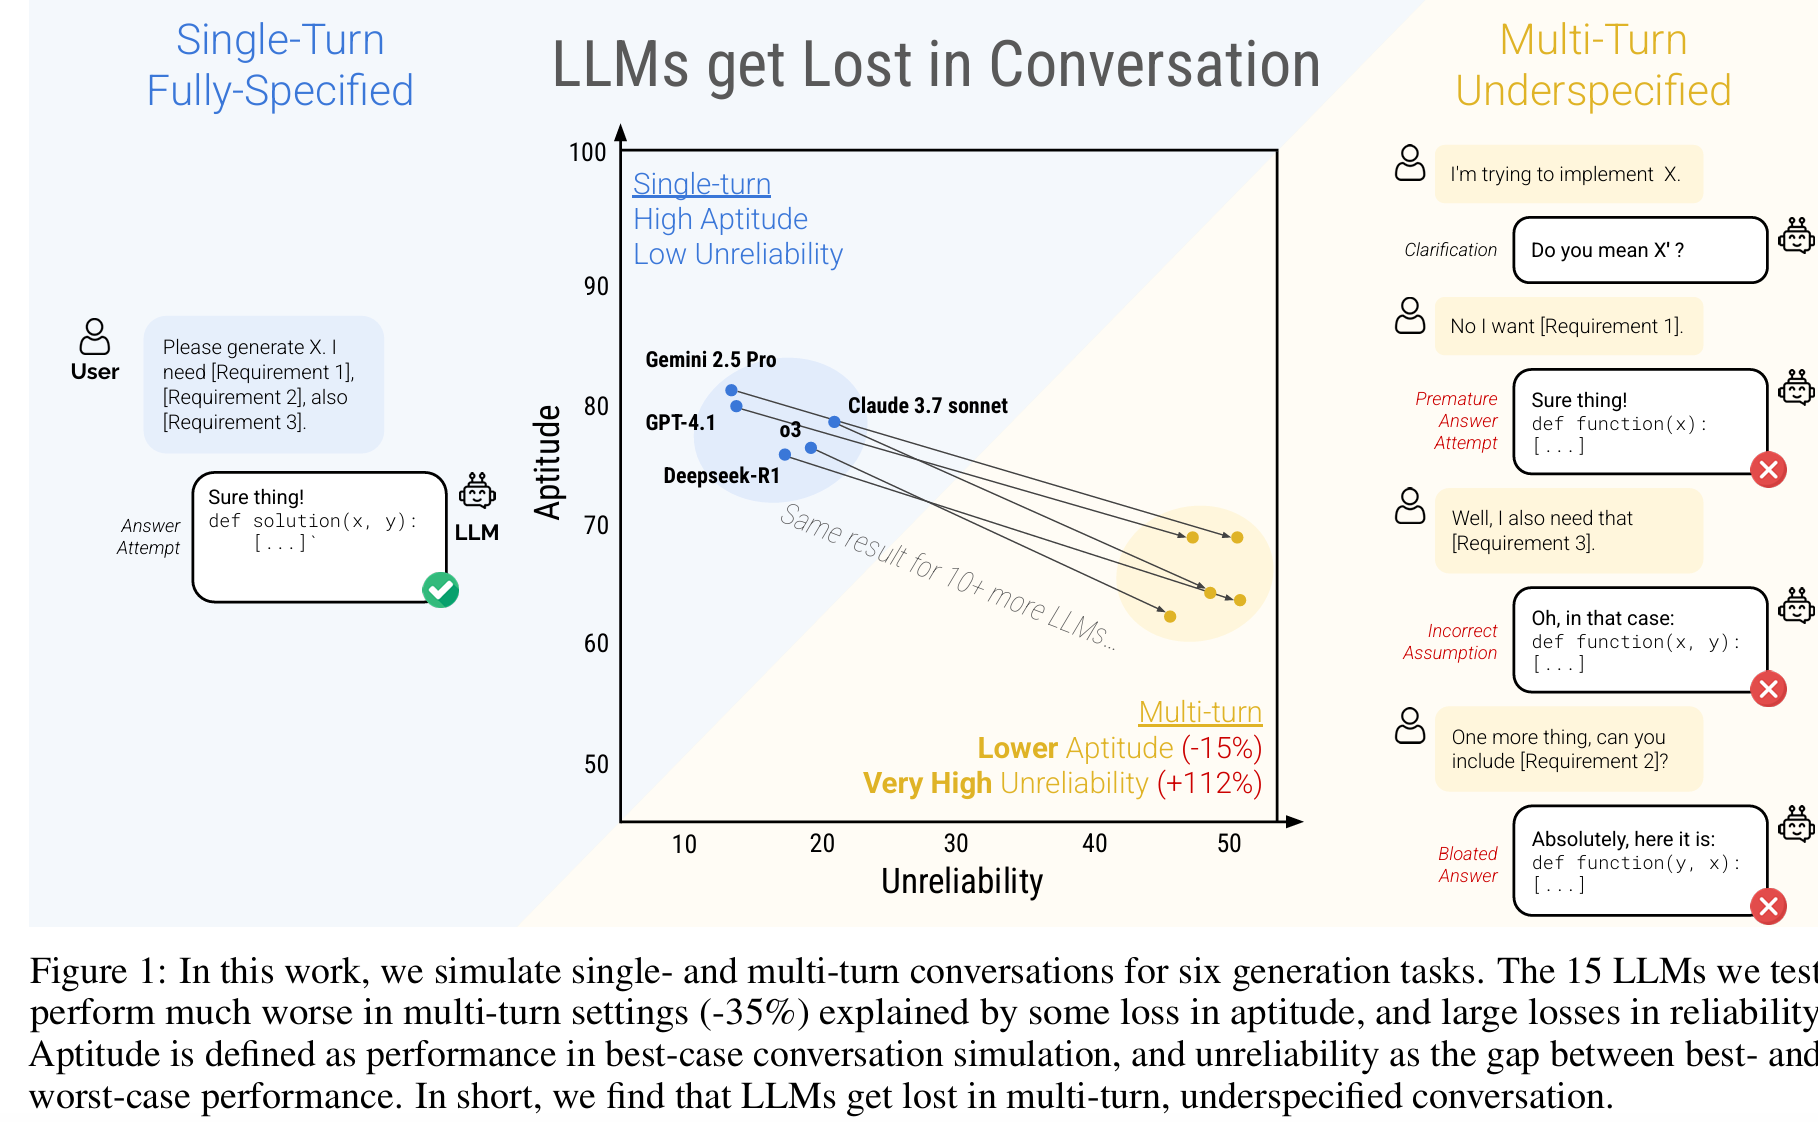
这也是我们的文章的一个出发点之一( https://arxiv.org/abs/2606.06090 )在研究的前期,我们也对这篇著名文章进行了复现。我们测试的benchmark类似高考数学的导数题,可能有3-6个subquestion,如果你一个一个问,性能可能不如一起问。并且有趣的是,就算这些subquestions他们毫无关联,一起问的正确率依旧更高。(使用了Gemma4-31B,qwen3.5-27B,GPT-5.4测试)
Multi-turn 的构造
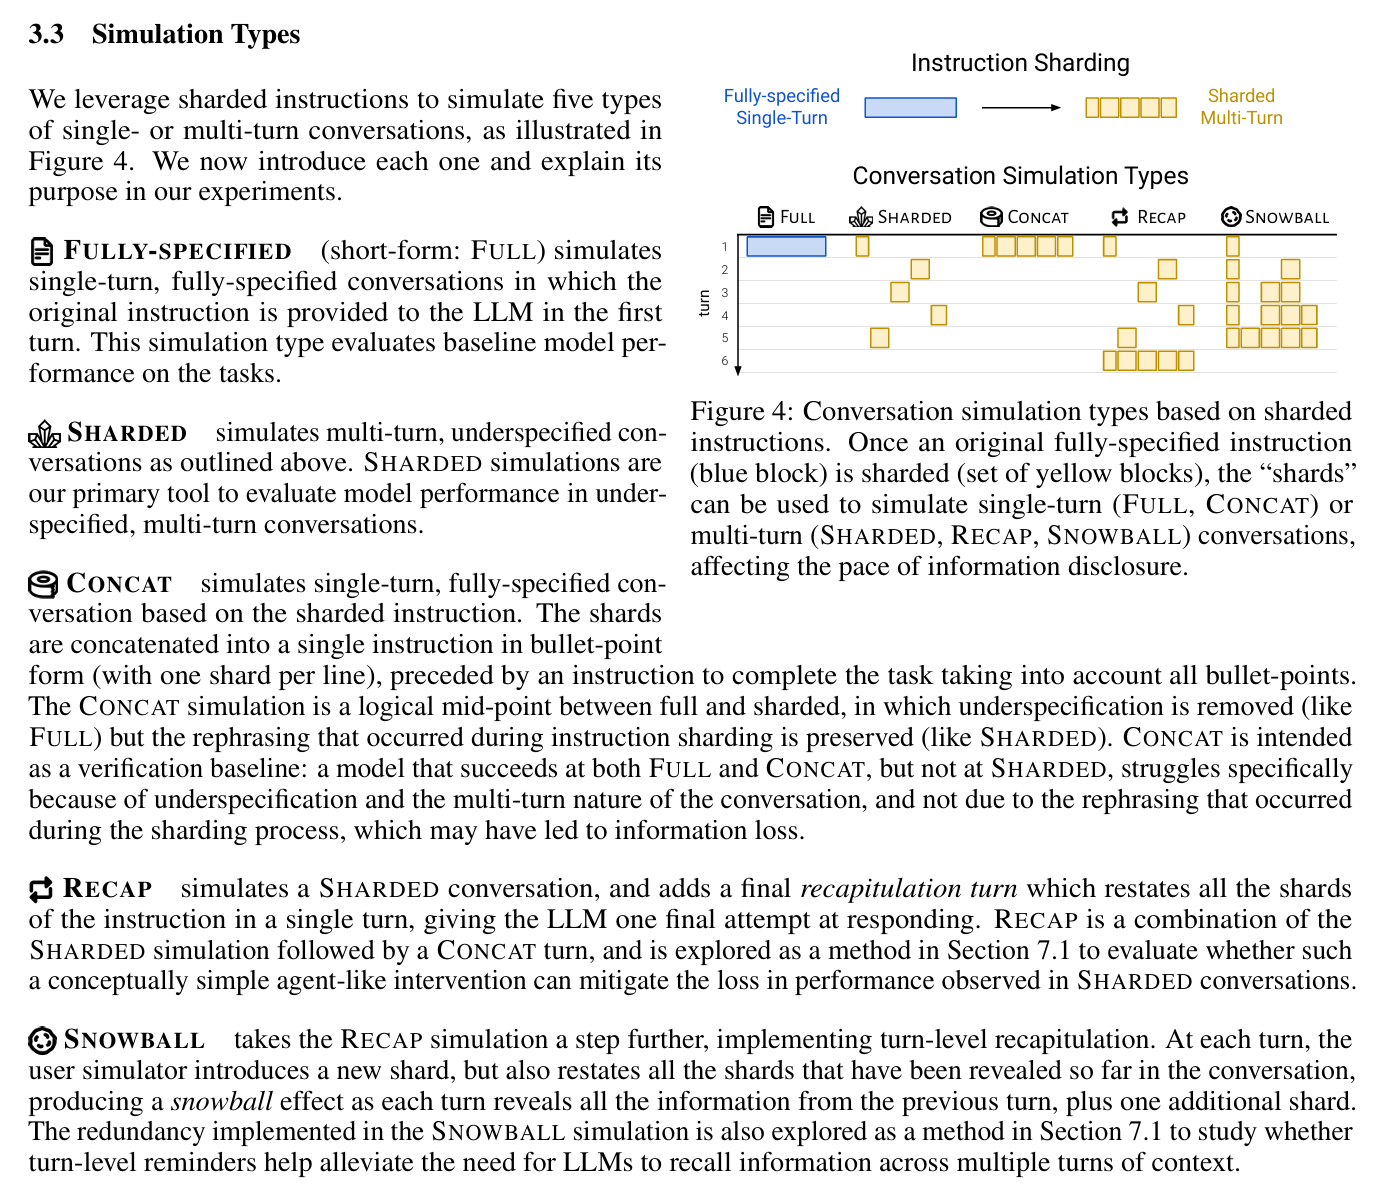
文章一共定义了 5 种对话模拟类型,其中真正的多轮类型有 3 种:
- Sharded(分片):把原始指令拆成多个信息片段,分几轮逐步透露;中间可能存在信息不完整,是论文主要研究的多轮场景。
- Recap(回顾):先按 Sharded 方式多轮对话,最后再加一轮,把所有片段重新总结一遍,让模型最后再尝试回答。
- Snowball(滚雪球):每轮都给出一个新片段,同时重述此前已经透露的所有片段,信息会逐轮累积。
另外两种是单轮对照:
- Fully-specified(完整指令):第一轮就给出完整指令。
- Concat(拼接):把所有片段合并成一条完整指令,一轮给出;保留了分片时的改写,但没有多轮和信息不完整的问题。
至于构造的方法,文章用了代码切段+GPT-4o重构问题来做。
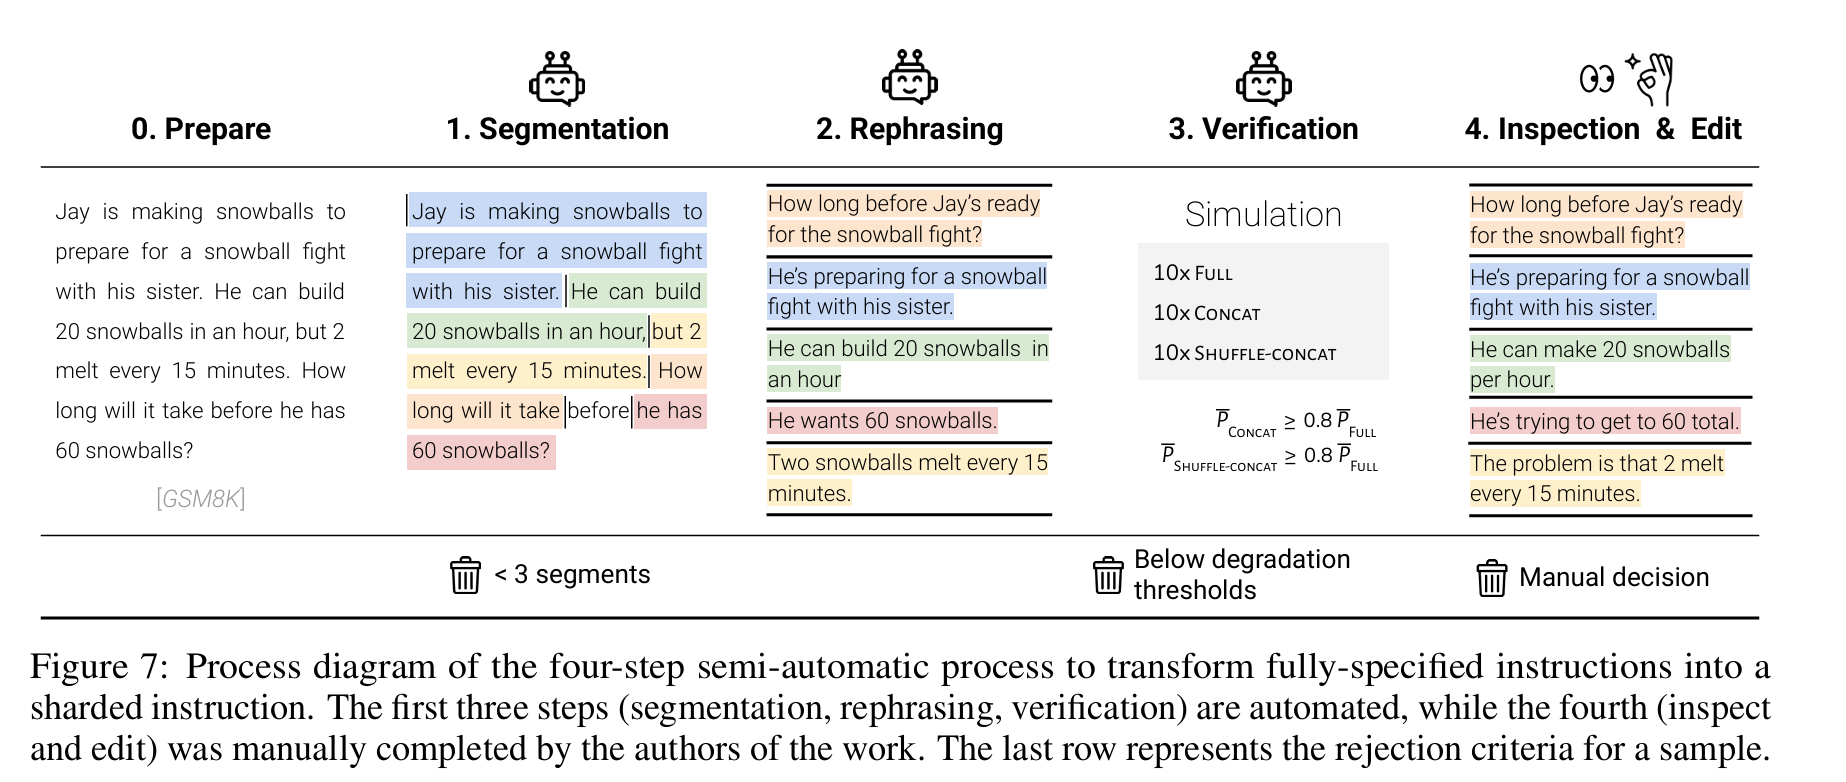
当然这里我们会有一个问题。用gpt-4o,会不会因为留下gpt-4o自己的语言指纹或者特征,造成评分上会有波动。不过整体来说,对文章的结论影响不大。就是可能会被AI审稿人攻击就是。
实验
测试数据集。从如今来看,GSM8K等可能会有点老。但是考虑到用的是gpt-4o mini,也应该没问题。
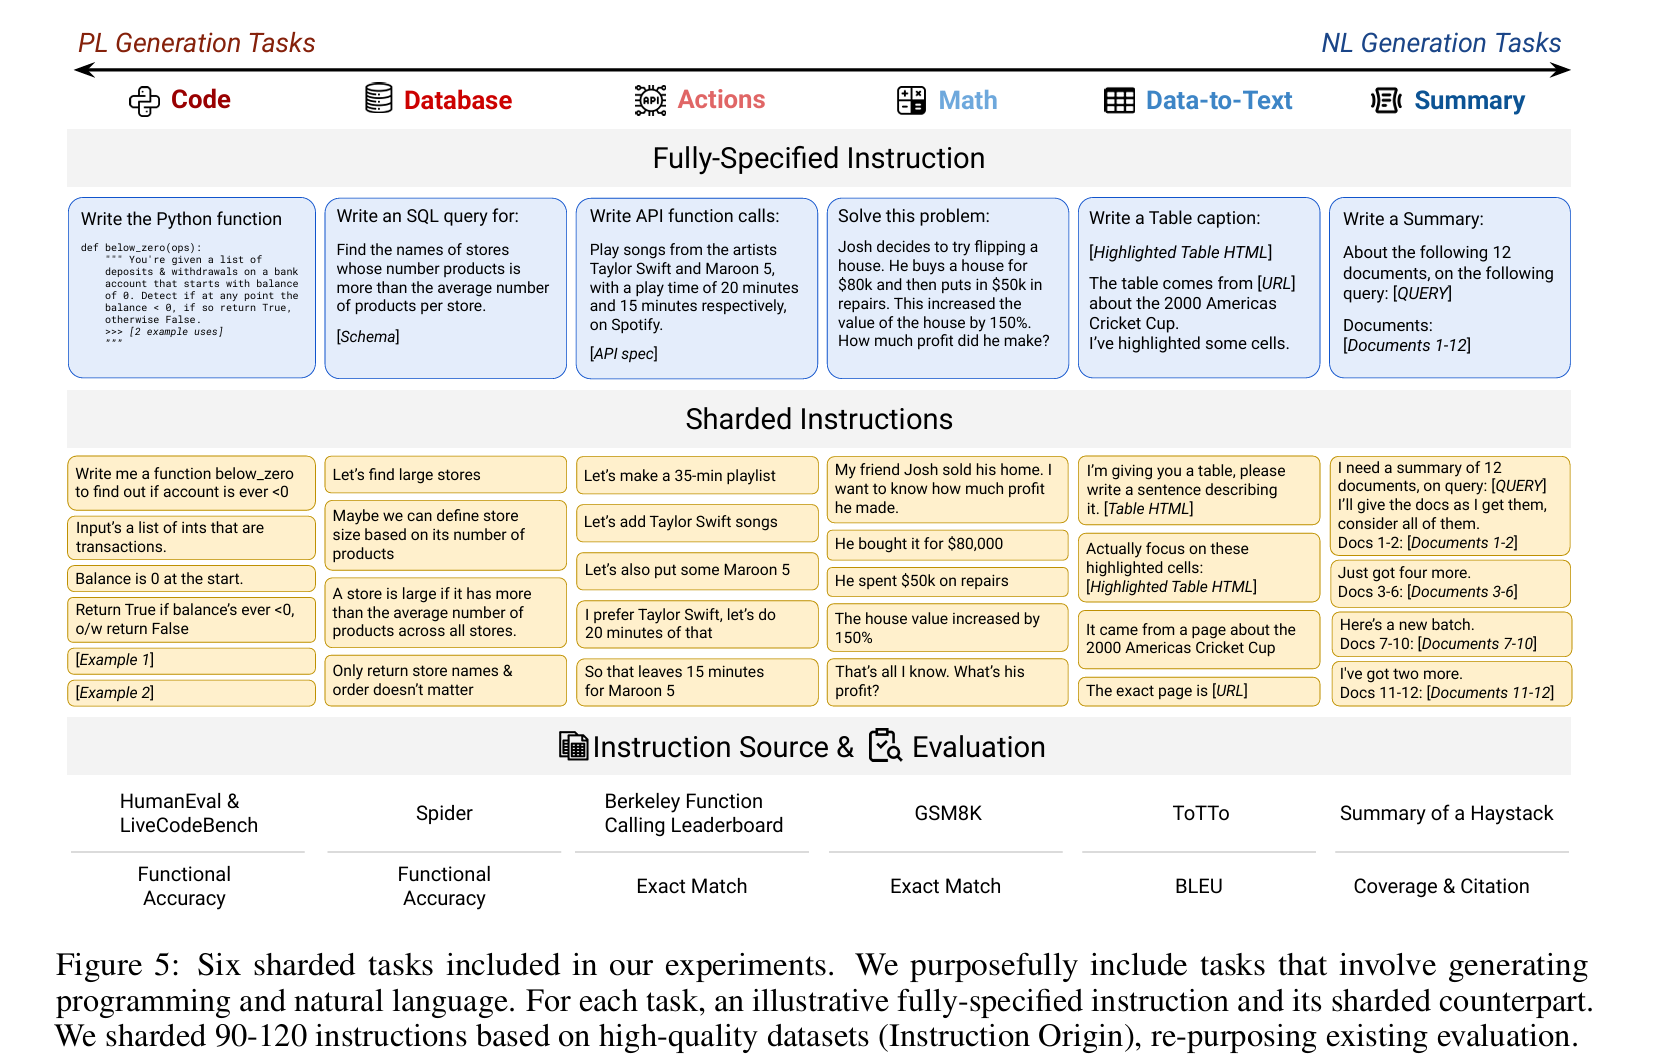
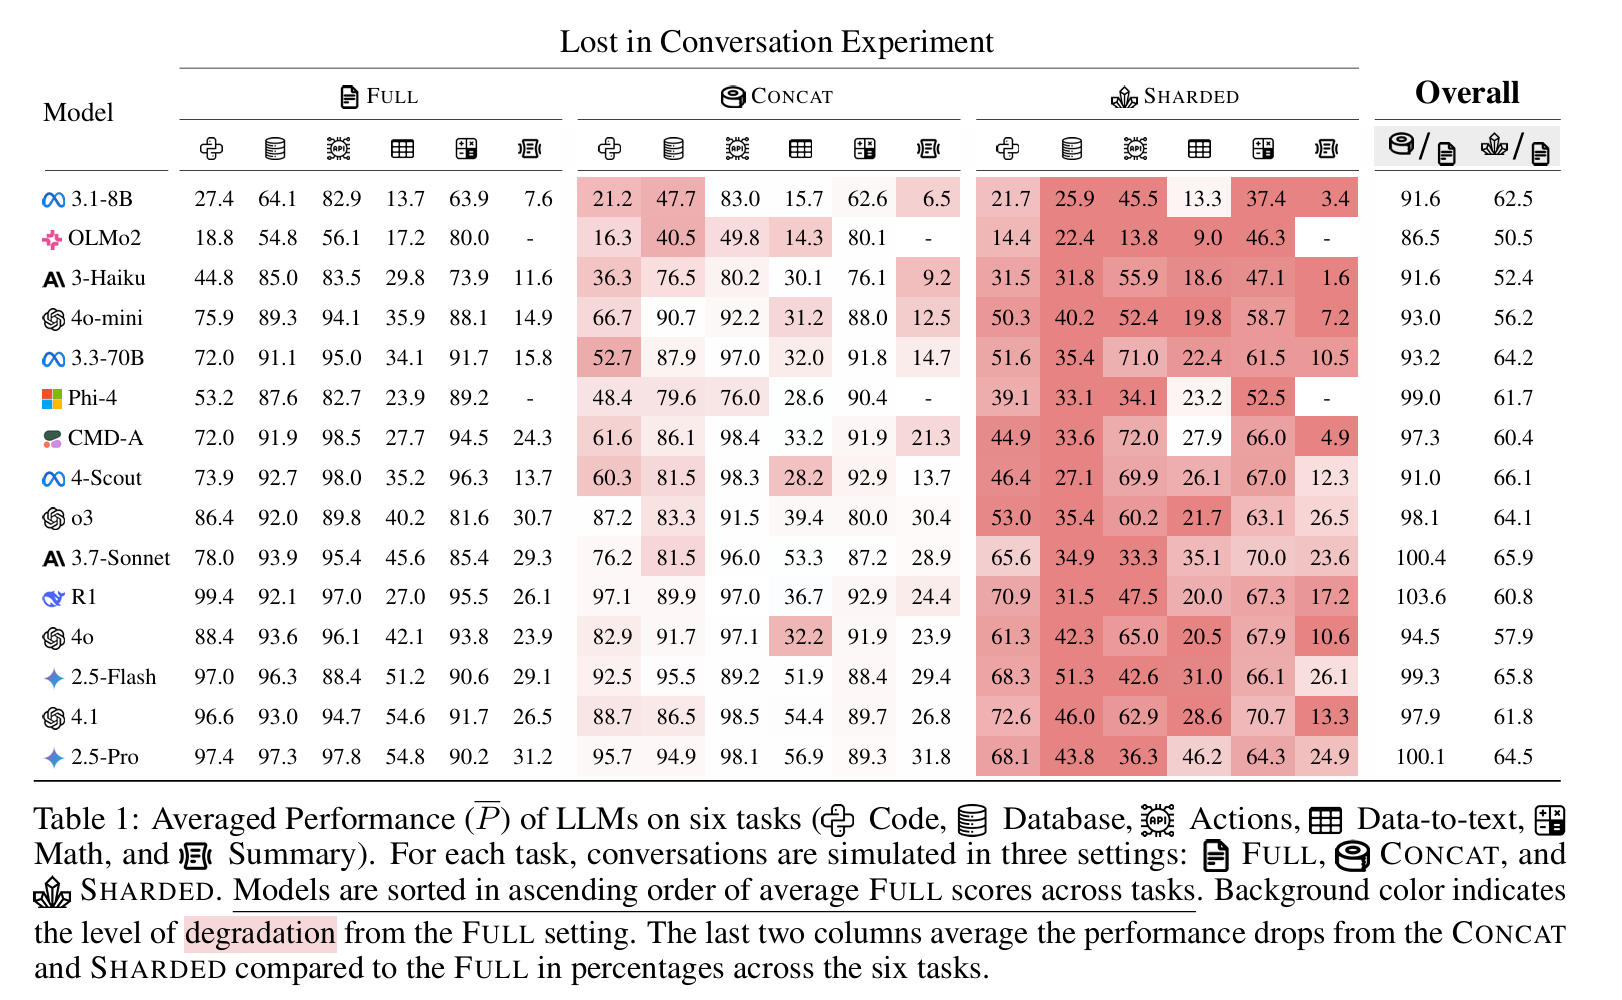
主实验。作者想用这张表说明:模型在完整、单轮指令下的高分,并不能保证它在多轮、逐步补充信息时也能保持同样表现。多数模型的 Sharded 分数都低于 Full 和 Concat。
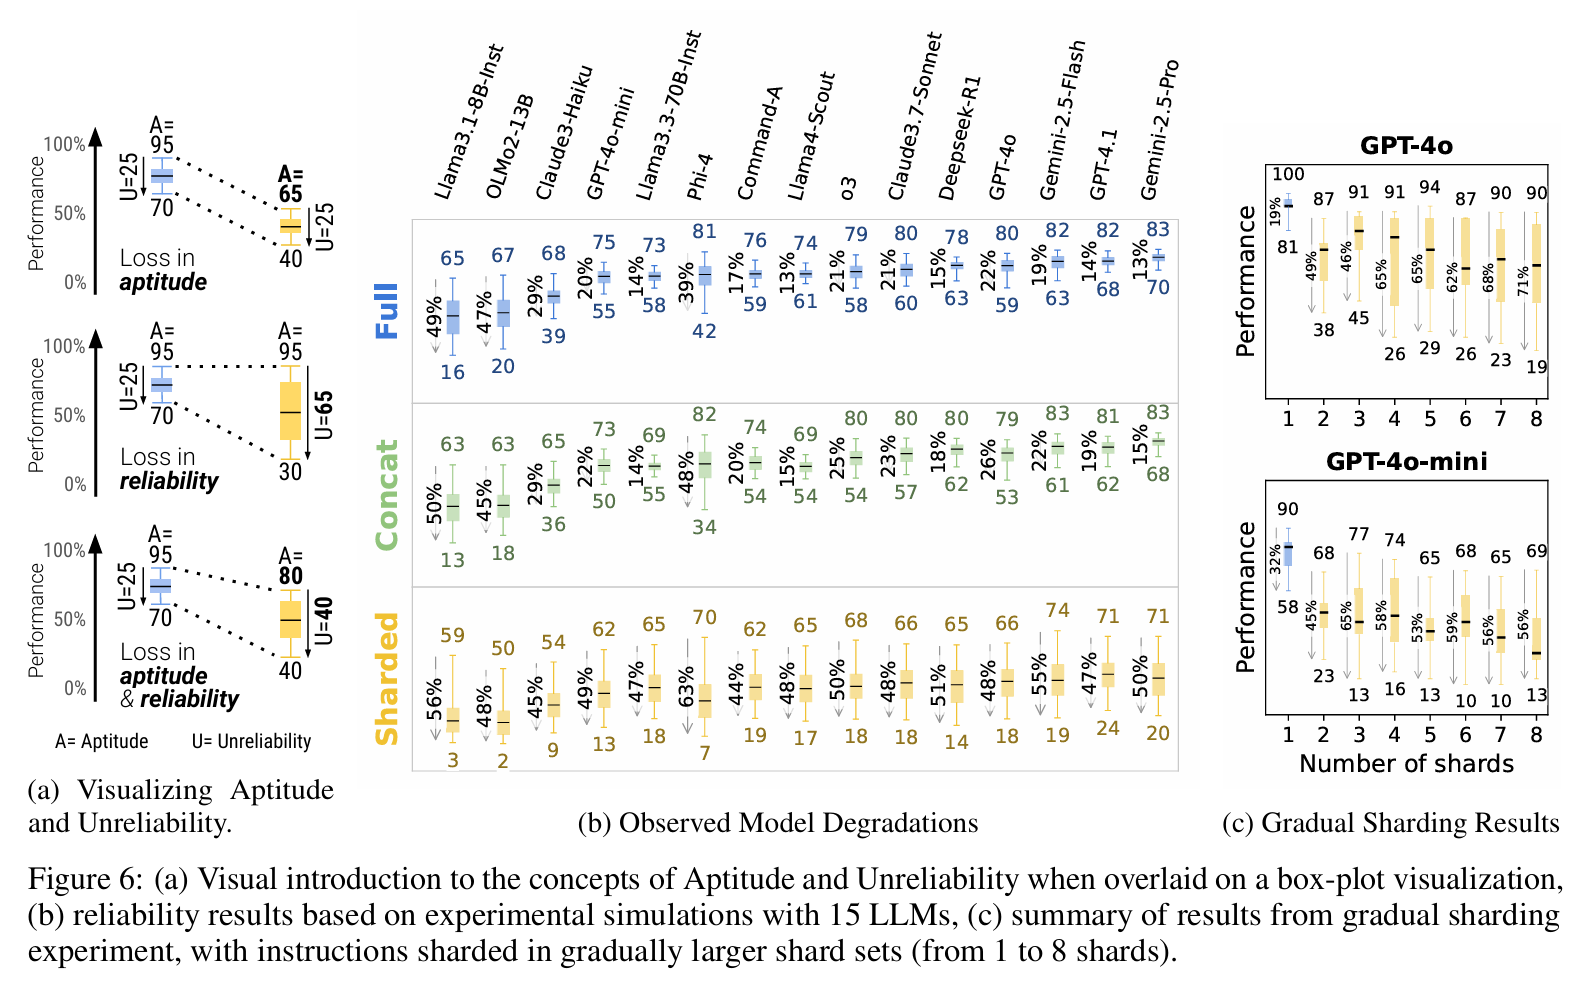
作者把表现拆成两个角度:
- Aptitude(能力水平):模型通常能做到多好。左上示意的是能力下降:从 Fully-specified 的 (A=95) 降到 Sharded 的 (A=65)。
- Unreliability(不稳定性):模型表现是否忽高忽低。左中示意的是平均能力仍为 (A=95),但不稳定性从 (U=25) 增至 (U=65)。
- 左下则是两者同时发生:能力下降,而且表现更不稳定。
图 6(b):不同模型在三种设置下的表现
作者比较了 15 个模型在 Full、Concat、Sharded 三种设置下的表现。总体上,Sharded(黄色)表现比 Full(蓝色)差;Concat(绿色)作为单轮对照,通常介于两者之间。
论文正文特别指出:一些更强的模型,例如 Claude 3.7 Sonnet、Gemini 2.5 和 GPT‑4.1,在多轮对话中的退化幅度也不小,平均约为 30%–40%。作者提醒,较小模型在 Full 设置下原本分数就低,因此可下降的空间较小;所以不同模型的百分比退化不能简单理解为它们受影响完全一样。
任务类型也有差别:Command‑A 在 Actions 任务上退化较少;Claude 3.7 Sonnet 和 GPT‑4.1 在 Code 任务上保持得较好;Gemini 2.5 Pro 在 Data-to-Text 任务上较好。这说明模型的多轮能力会因任务领域而异。
图 6(c):信息分得越多,表现会怎样?
右侧展示 GPT‑4o 和 GPT‑4o-mini 随 shard 数量变化的表现。整体上,信息被拆成多块、分轮提供时,模型表现会明显下降;但曲线不是平滑递减的,尤其 GPT‑4o 在 shard 数为 2 时就出现了较大的下降。
这也和你刚才提到的审稿人质疑有关:作者后来解释,渐进切分实验只选了原本就有 8 个 shard 的复杂指令,所以即使改成 2 个 shard,每轮仍会透露相当多的信息,结果可能因此出现跳变。
页面下方的结论
作者还发现,推理模型 o3 和 DeepSeek‑R1 的退化幅度也和普通模型相近。单纯增加推理计算量,并没有让模型更擅长规划多轮对话。作者推测,一个原因是推理模型的回复平均长约 33%,包含更多假设,可能让模型混淆“用户实际提出的要求”和“自己前几轮说过的话”。
Get lost 的原因
详细分析在论文附录 F「Qualitative Analyses of Simulation Logs」。我觉得真的,这部分内容应该放进正文里,都是非常好的观察。在实际的科研里,我们也注意到了这些问题,这些结论给我们在概括总结问题上真的提供了很好的帮助。当然正文长度有限,作者的充分实验做的很好。
论文把观察到的表现归纳为四种:
- 太早给完整答案。
信息不足时,模型仍会尝试解完整任务,于是不得不自行补上缺失条件。新信息后来出现时,早先的假设可能与它冲突。作者在 Code 和 Math 上观察到,第一次作答越晚,平均表现通常越好:最早作答组平均分 30.9,最晚作答组是 64.4。这是相关性证据;作者认为错误假设可能是原因,但这个分析本身不能单独证明因果。
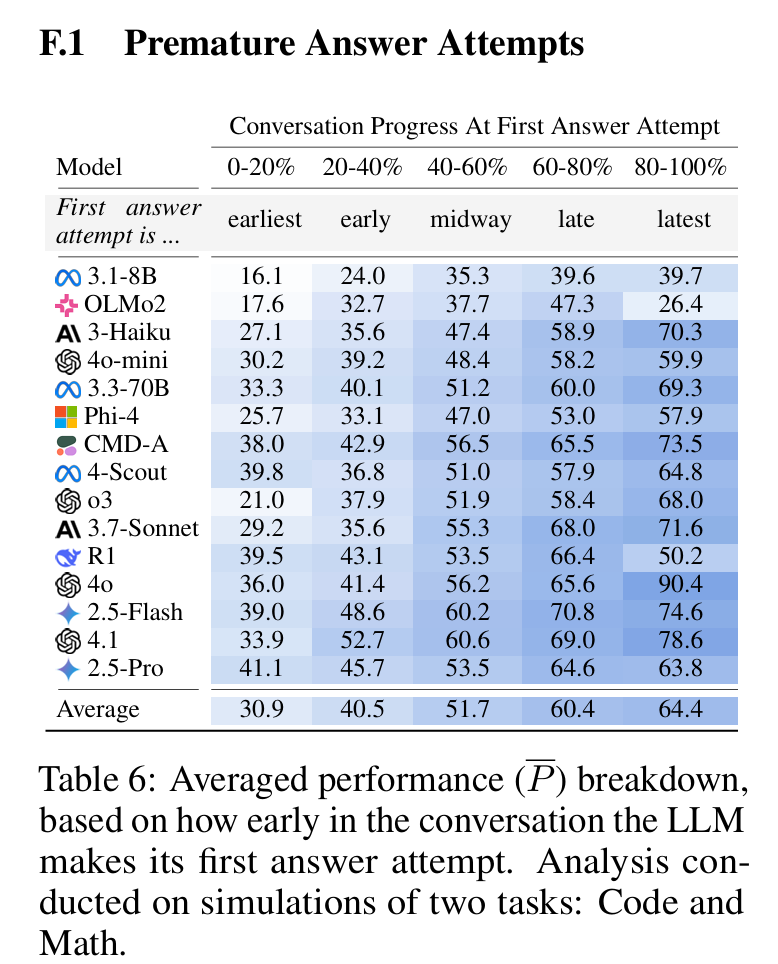
表格把对话按“模型第一次正式尝试回答时,整个对话已经进行到多少”分成五组:
- 0–20%:刚开始不久就尝试作答
- 80–100%:快到对话末尾才第一次尝试作答 数字是该组的平均表现,分析只涵盖 Code 和 Math 两类任务。最下面的 Average 显示:第一次作答越晚,平均分总体越高——从最早作答组的 30.9,升到最晚作答组的 64.4。作者据此认为,模型在信息不完整时太早给方案,可能会先猜错一些条件;用户后续补充信息后,模型又受到早先答案的影响,没能及时修正。先澄清需求、等信息多一些再给完整答案,通常表现更好。
-
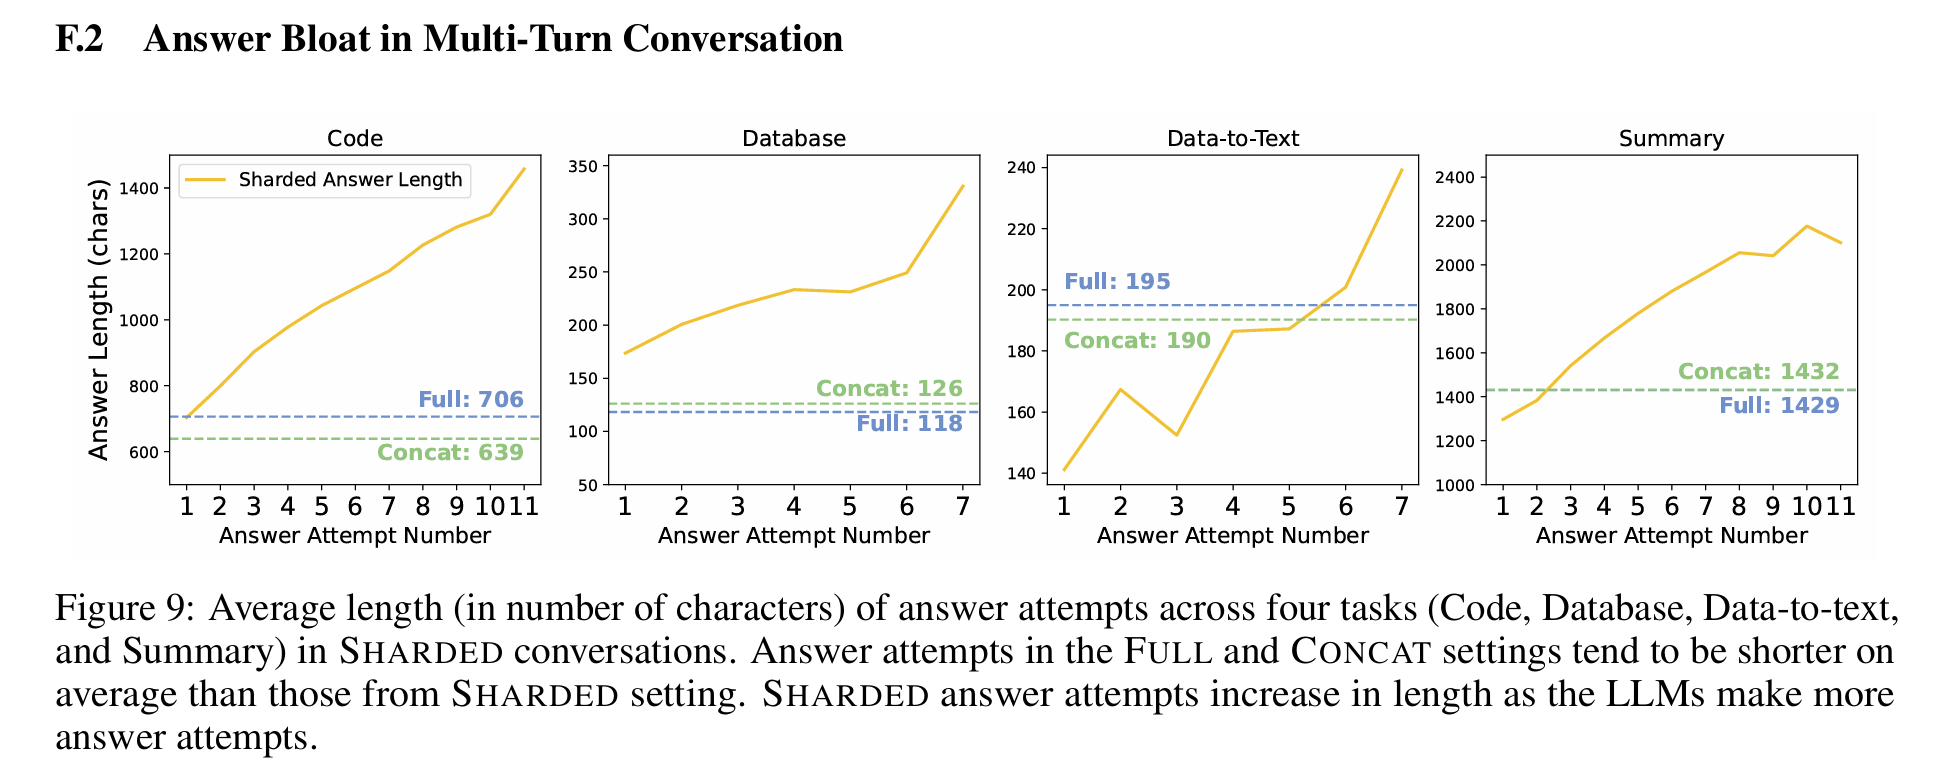
被自己先前的错误答案“锚住”,答案越改越臃肿。
后续轮次里,模型似乎没有充分推翻旧假设,而是在之前的答案上继续修补。Sharded 对话中的最终答案,在一些任务里比 Full 或 Concat 的答案长 20%–300%;即使只看最终答对的例子,代码也平均长 27%,SQL 长 14%。作者把这种现象叫作 answer bloat。实验见rebuttal里图片F2 -
中间轮次的信息更容易被漏掉。
在需要总结并引用不同轮次所给文档的任务中,模型更容易引用第一轮或最近一轮的材料,较少引用中间轮次。比如第八轮总结里,来自第八轮文档的引用占 20%,来自第二、三轮的各约 8%。作者称之为 loss-in-middle-turns。
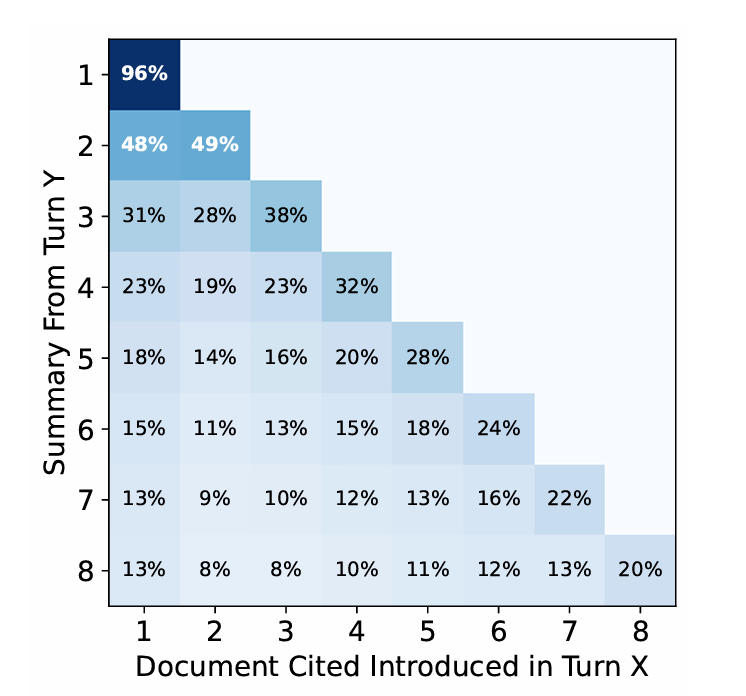 Figure 10: Analysis of citation patterns in summaries generated by LLMs with the SHARDED simulation. At each turn, the LLM generates an updated summary (y-axis), which includes citations from the documents that have been revealed up to this turn. Percentages in a row do not add up to 100% due to citation hallucinations that occur for some models.
- 回复太长,模型可能把自己的话和用户要求混在一起。
作者发现,更长的回复往往包含更多假设,可能使模型难以区分“用户实际说了什么”和“自己前面推测或承诺了什么”。推理模型平均回复还比非推理模型长约 33%,但推理计算本身没有消除多轮退化。这里“长回复导致混淆”主要是作者提出的解释,证据还不足以证明它就是根因。
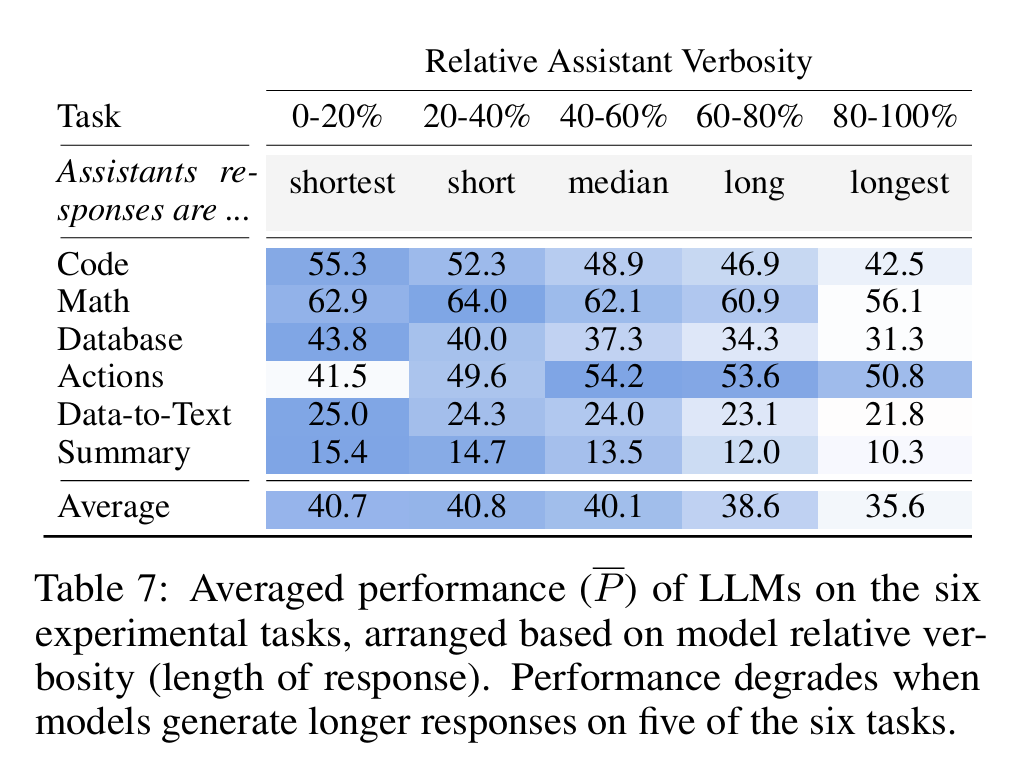
表格显示,最下面的平均分从短回复档的 40.7 左右降到最长回复档的 35.6。作者据此认为,较长的回复通常伴随着更多假设或猜测,可能让模型在后续轮次里更难跟住用户真正提出的要求。
具体评估存疑。可能更好的是要做实际的runcase context分析。
思考:这些问题的根本问题是什么?他们能被根本解决吗?比如他们是训练时缺乏引导的问题,我们可以通过更多这方面训练数据来提升他们。又或者,这些问题是本身context的复杂性,随着模型能力的提升,这些context问题就自然而然地解决了?(从不同模型的表现看,他们应该属于是增加了context的复杂性;我们当然可以用堆训练数据的方法去尝试提升他们)
审稿人
得分很不错:10 8 8 6
Openreview link: https://openreview.net/forum?id=VKGTGGcwl6
AC
AC对审稿人的concerns进行了总结,我看完了所有context,总结的很准确,并且也是agent文章里很多很重要的问题:
- 评分的问题 Scoring Fairness: Reviewer C44a questioned if models were unfairly penalized. The authors clarified that the assistant is given as many chances as there are shards, actually favoring the assistant over single-turn baselines; despite this advantage, performance remains poor.
- get losts 会不会是上下文长度的问题 Context Length: Reviewer ig5S raised concerns about token limits. The authors confirmed the tasks typically require fewer than 20k tokens, well within the context windows of almost all models tested.
- 分块的问题 Shard Granularity: Reviewers worried the sharding was unnatural and hindered the model’s performance. Authors detailed a semi-automatic process that involves manual inspection and editing to ensure that shards represent natural information splits.
C44A
审稿人C44A认为文章实验设计把指令切得过细、对话轮数拉得过长,可能夸大了多轮对话带来的记忆与干扰问题。(Realism of sharding. - Atomizing instructions into many non-overlapping single-element shards is artificial; human interactions usually involve 2–3 rounds with decreasing element counts. The current method forces the model to fill context with speculative content, amplifying interference.)
同时ta认为,来自LLM自己评分的/手工评分问题。这个也是agent很大的问题,我们在实际的测试里,经常发现来自格式以及很多答案准确性的问题。这也告诉我们,这些分数有时候如果你不注意,是会有水分或者不确定性存在的。(Answer-extraction and scoring mechanism is unclear. - If each attempt is scored against the full prompt, early correct partial answers may be unfairly penalized; if scored against the current shard, comparability with single-turn baselines is lost.)
但是我认为作者的rebuttal真的很好:
Q1:关于答案提取与评估的说明。
在包含 (N) 个信息片段(shard)的对话中,助手最多可以尝试回答 (N) 次。只要其中任意一个候选答案被判定为正确,我们就将整段对话记为“正确”。换句话说,只要对话还在随着新片段继续进行,我们就会给助手新的作答机会。如果助手能在所有片段都揭示之前就给出正确答案(例如,正确猜出了尚未提供的片段),它就能获得满分,对话也会提前结束。
您指出得很对,图 10 没有正确呈现模拟过程:实际上,每一轮都会进行答案提取和评估,只是模型在这些轮次中都没有给出正确答案。我们会更新图 10,展示每一轮的答案提取和评估结果,以消除这一误解。希望这能澄清评分流程;如仍有不清楚之处,我们也很乐意进一步说明。
需要指出的是,在 Sharded 设置下,助手有多次作答机会;从技术上说,这使它比单轮设置更占优势,因为单轮设置最多只有一次作答机会,也就是唯一一轮中的那次回答。
Q2:关于提前答对是否公平。
审稿人指出得完全正确:在 Sharded 实验中,助手有可能“碰巧”给出一个被评为正确的答案。这可能有多种原因,包括:(1)助手对基准题目过拟合,因为我们的实验包含 HumanEval 和 BFCL 等常见基准中的指令;(2)助手靠运气猜对了尚未揭示的片段;(3)评估不够全面,未能区分部分正确的解答与完全正确的解答。
这些因素会使 Sharded 模拟相较于单轮设置占有优势——单轮设置按设计提供的作答机会更少。然而,我们仍然观察到 Sharded 设置下的性能大幅下降。这说明,在“对话中迷失”(lost in conversation)的情形下,单靠不断尝试作答的简单暴力方式,并不足以取得高分。我们会在讨论部分补充这一点,因为它关系到不同模拟设置之间的公平性与优势差异。
Q3:关于原子化片段的自然性。
首先,我们同意审稿人的看法:我们所做的模拟在概念上比较简单,无法体现真实用户与 AI 系统多轮交流中可能出现的所有复杂情况。不过,我们在切分信息片段时做了不少工作,并对每个片段进行了人工审查和编辑(见附录 C),尽量让片段代表自然的信息切分,避免把本来更适合放在一起的信息人为拆开。为此,我们有时会合并原先拆开的片段,也会根据需要重新安排片段。
此外,用户模拟器由 GPT-4o-mini 实现。我们要求它选择最适合当前对话情境的片段,例如在助手提出澄清问题时,选择与该问题最自然匹配的片段。因此,对话不只是通过随机填充信息槽位来推进,而是力求更加自然。
我们会在讨论部分说明这些设计选择,并指出仍需要更自然的模拟环境。简言之,我们设置了一些保障措施,以确保模拟达到最低质量要求;但我们也同意,要实现真实的模拟,还需要进一步研究。
Q4:关于回复类型的说明。
回复类型只用于判断是否触发答案提取与评估(即图 2 中“Strategy Classifier”右侧的分支箭头)。如果回复类型是“尝试作答”(answer attempt),系统就会提取并评估候选答案;否则——也就是属于其他六种非尝试作答类型之一——对话会继续,并揭示下一个用户片段。
我们的意图是实现一个分类器,沿用 Herlihy 等人(2024)已有的回复类型分类,因此总共设置了 7 种回复类型。我们会修改第 147–153 行中对模拟过程的示例说明,以减少混淆。
感谢您指出这些问题。
Weaknesses: -It’s a pity the root causes of conversational model failures are buried in the appendix.
ig5S
Questions: -The example in Fig. 10 is contestable: the expected final answer is 85k calories, yet the assistant never provides a single final total: it reports separate values for the two pastry types. Reiterating the original request (“calculate the total calorie count of Andrew’s pastries”) at the end would likely have produced the correct aggregate. Is this a real failure ? I’m wondering if there would be other types of ‘lost in conversation’ issues.
-Did you verify that, for models with smaller context windows, the full sharded conversation does not exceed their limit? Context capacity varies by model (some are maybe ~64k tokens, some much more), so overlength dialogs could confound the results.
这里补个appendix的图片。整体来说,都没有到性能下降的context的长度
-In the gradual sharding experiments, we observe a performance degradation for N ≥ 2 shards. However, how can we explain the fact that increasing the number of shards (up to 8) does not necessarily lead to higher loss? In particular, the performance for 2 and 8 shards appears comparable in Figure 5c.
这里重点看作者回答3: Q3: We agree that the gradual sharding result, and the large drop at N=2 followed by large unreliability from 2-8 shards is surprising. Part of this is due to the fact that the experiment relies on a lower number of instructions, since we only selected original instructions with 8 shards (as we wanted to control for information granularity). These 8-shard instructions are more complex than the average shards in our corpus (with 3-5 shards), and we believe that this filtering led to the selection of more complex instructions. Because of this even the 2-shard version of the shards are complex (since the equivalent of 4 shards is revealed at each turn). A different experiment would involve simply running the analysis with the existing shards in our corpus, and not resharding as we did. This would likely yield more gradual degradation as the reviewer expected, but it would not control task complexity while increasing granularity, as we wanted to demonstrate with the experiment. We will add this discussion on the design decision of the gradual sharding experiment to the paper. In short, understanding the effect of information granularity on an assistant model’s performance is challenging.
之后从 2 增到 8,表现又变得很不稳定,而不是逐步变差。
作者认为,原因之一是实验只选了原本就有 8 个 shard 的指令,再把它们重新切成不同数量的 shard。这样做是为了控制任务内容,让实验更集中地观察“信息粒度”变化的影响。但原本能拆成 8 个 shard 的指令,本身就比语料库里常见的 3–5 个 shard 的指令复杂。
因此,即使把它改成 2 个 shard,每轮也相当于一次透露原来 4 个 shard 的信息,任务依然很复杂。性能一开始就大幅下降,可能与任务难度有关;后面继续增加 shard 数量时,结果就显得不稳定。
另一种做法是直接使用语料库里原有的 shard,不重新切分。作者认为这样可能会得到审稿人预期的、更平缓的性能下降,但任务复杂度也会跟着 shard 数量变化,难以单独判断信息切得更细造成了什么影响。
我们在做自己的实验时也观察到了这一点,就是长context/超多轮对话的问题本身就比3-4轮的对话问题难,此时分数是一种不稳定。并且很不幸的是,我们需要先quant好什么是问题的“难度”。这个问题在当时我们做paper的时候也讨论过。最后我们认为“难度”需要多个model进行测试才能得到。难度是一个非常难量化的事物。
没有错误纠正
审稿人问:当模型做出错误假设时,用户模拟器从不提供反馈;它只会继续展示碎片。这意味着任务不仅测试了输入不充分处理能力,还测试了在没有外部反馈下的自我纠正能力。在真实对话中,用户——尤其是专家——经常会在过程中澄清或纠正。如果不比较有反馈与无反馈两种情况,就无法区分性能下降到底有多少是源于输入不充分本身,多少是由于缺乏纠正。
回答 Q2: The idea to test corrective feedback is novel and interesting. As mentioned above, the user simulator was implemented in an LLM, and we observed that there are occasions when it generated user utterances in ways that sounded corrective (“No, I want to sort in XYZ way”), however, this was not encouraged in the instruction and was relatively rare. The recap experiment (in Appendix G1) is another experiment related to corrective feedback. In this experiment, a final turn of conversation is conducted where the user states that the solutions provided are not correct, restates all the shards in one turn (as a bullet-list) and instructs the assistant to try one last time. The results of the experiment confirm that such corrective feedback did help boost performance a little, but falls short of closing the gap with single-turn performance. We will describe more advanced user simulation requiring more realistic patterns including corrective feedback in the discussion.
总结
文章的实验量和分析工作还是很大的,尤其是在那个没有agent的时代,都是比较累的苦力活。并且可以从这篇文章看到agent文章研究的特点:问题多而杂,很难控制变量,要想拿到更全面的问题情况,需要进行大批量的实验和测试,然后用一些统计的分析方法。每一个方法都有很多种指标,我在做这些实验的时候也经常头昏或者搞错。当然这可能也是AI研究时经常出现的情况,我们的config太多+研究一个充满扰动的高维空间,控制变量很难,并且想做全这些测试在学术界估计会比较昂贵。
如何理解get lost in the middle?我个人认为整体的原因是,multi-turn带来了更多的context复杂度以及无关context(比如大量的对单个问题的思考,可能对后续问题有噪声)。整体来说,文章给了我们很多很有意思的观察和启示,启发了后面很多的研究。比如,应该怎么样组织和管理context,从而减少噪声?应该怎么样通过组织对话和问题,提升任务的成功率?在探索类任务里,我们经常需要转变方向,此时会在之前留下大量的无意义context,如何随时灵活的变换方向?我们的harness在做“压缩对话”时,应该怎么压缩?这些都是这篇文章在agent任务里带来的思考。
去年我记得在软件工程课里,我们就应用里这样的方法。我们先确定了全部的需求,再进行实现,效果和成功率都非常好,这样的瀑布模型让LLM在实现时能随时查文档。当然随着模型能力的提升,模型在多轮对话以及随时更改需求里的稳定性也提升了很多。
想起在agent memory研究里,之前也有人指出过这个问题。是你的memory重要,还是你在对问题理解的那个衔接层重要。并且这两个如何分层?从目前看,最有含金量的是后者。这可能也是某种bitter lesson吧。
If you need to cite this post
Haibin Lai. (November 20, 2026). “ICLR26 LLMs Get Lost In Multi-Turn Conversation” [Blog post]. Retrieved from https://www.haibinlaiblog.top/posts/iclr26-llms-get-lost-in-multi-turn-conversation/
@online{lai-iclr26-llms-get-lost-in-multi-turn-conversation,
  title={ICLR26 LLMs Get Lost In Multi-Turn Conversation},
  author={Haibin Lai},
  year={2026},
  url={https://www.haibinlaiblog.top/posts/iclr26-llms-get-lost-in-multi-turn-conversation/},
}
DISCUSSION
Comments
No imported comments yet. Start the conversation below.
Leave a comment with GitHub