阿里云百炼 Qwen 请求 Trace 分析
- Data Mining
- 14小时前
- 19 Views
- 0 Comments
- 2691 Words
Reader mode is not fully supported on this site; please use it with caution.
数据来自阿里云百炼上的 Qwen 推理集群,Apache 2.0 开源。
文中统计均由全量扫描四条 JSONL 得到(每条数据约 2 小时)。
这份开源请求数据集的仓库存有2小时 C 端聊天、B 端 API、长思维链、代码助手四类流量。
这是什么数据?
Qwen-Bailian Anonymous Dataset 每条记录有到达时间、输入/输出长度、会话父子关系、请求类型,以及按 16 token 一块 哈希后的 hash_ids。
配套论文为 ATC'25 的 KVCache Cache in the Wild。官方 replay 工具:blitz-serving/trace-replayer。
一条记录参考:
{
  "chat_id": 159,
  "parent_chat_id": 55,
  "timestamp": 61.114,
  "input_length": 521,
  "output_length": 132,
  "type": "text",
  "turn": 2,
  "hash_ids": [1089, 1090, 1091, 6326]
}
timestamp 是相对秒,文件开头为 0。parent_chat_id = -1 表示一轮会话的根。hash_ids 已经是 chat template 之后 的 token 块,replay 时不要再套一遍模板。
点开:四条文件各自对应什么场景
| 文件 | 场景 | 本文简称 |
| --- | --- | --- |
| qwen_traceA_blksz_16.jsonl | C 端交互聊天 | To-C |
| qwen_traceB_blksz_16.jsonl | B 端 API 任务自动化(采集标注 2024-12) | To-B |
| qwen_thinking_blksz_16.jsonl | 长思维链 | Thinking |
| qwen_coder_blksz_16.jsonl | 代码生成 | Coder |
每条都是约两小时的独立切片,**不是**按线上真实 mix 抽的同一段流量。
点开:他们怎么匿名的
1. token 按 16 个一组,做加盐 SipHash-2-4
2. 哈希值再映射成全局整数,切断和原文的对应
3. chat_id 换成顺序整数,对不上账号
4. 墙钟时间全部平移到从 0 开始
所以你能复现「哪些块以前见过」,不能复现「用户说了什么」。
四条 trace
| To-C 聊天 | To-B API | Thinking | Coder | |
|---|---|---|---|---|
| 请求数 | 43,058 | 172,800 | 10,812 | 43,011 |
| 平均 / 峰值 QPS | 6.0 / 9.8 | 24.0 / 37 | 1.5 / 10.5 | 6.0 / 9.2 |
| 多轮比例 | 46% | 0% | 11% | 39% |
| 输入中位数 | 1,046 | 574 | 3,680 | 4,540 |
| 输出中位数 | 376 | 39 | 1,666 | 469 |
| 输入 P99 | 14,365 | 6,294 | 24,973 | 14,407 |
| 输出 P99 | 1,641 | 1,006 | 34,687 | 5,842 |
| 全局 KV 块复用 | 60% | 62% | 46% | 66% |
- To-B 全是单轮,输出中位 39 token,平均刚好 24 QPS。这是模板化 API。
- To-C 为 chat。 将近一半多轮,还夹着搜索和图、文件。
- Coder 吃 prefill。 输入中位 4540,会话最长 54 轮。
- Thinking 吃长 decode,而且最突发。 均值 1.5 QPS,10 秒峰到 10.5,峰均比约 7。
点开:To-C / To-B 请求类型构成
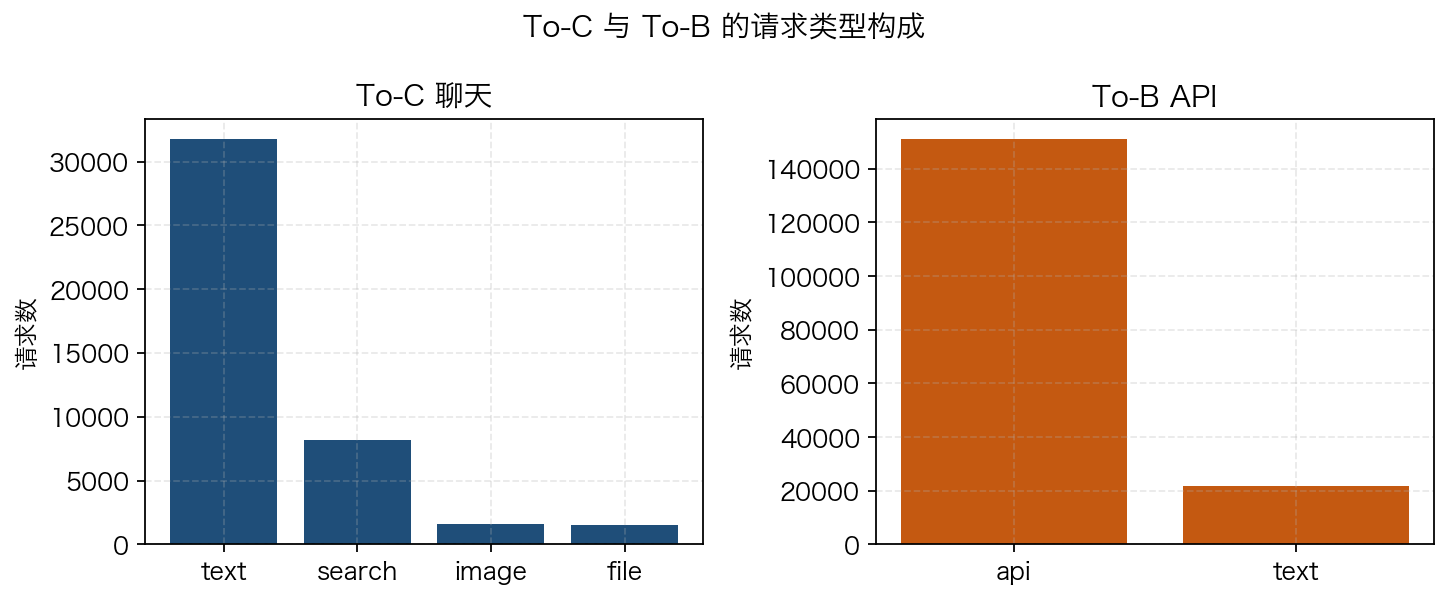
To-C:text 73.7%,search 19.0%,image 3.8%,file 3.5%。
To-B:api 87.3%,text 12.7%。B 端几乎没有「你问我答」的会话形态。
记录里没有模型名、用户、语言。能再拆的只有 type。Thinking / Coder 各自只有一个取值。KV 复用下面按该 type 自己的时间序列重算,避免被别的类型带高。
| 条数 | 占比 | 均/峰 QPS | 输入中位 / P99 | 输出中位 / P99 | 多轮 | 子集内块复用 | 相对父请求前缀 | |
|---|---|---|---|---|---|---|---|---|
| To-C / text | 31,744 | 73.7% | 4.4 / 7.6 | 790 / 8,202 | 371 / 1,714 | 48% | 71% | 60% |
| To-C / search | 8,187 | 19.0% | 1.1 / 3.0 | 5,293 / 16,635 | 419 / 1,311 | 46% | 51% | 90% |
| To-C / image | 1,617 | 3.8% | 0.22 / 0.8 | 369 / 2,764 | 69 / 817 | 8% | 85% | 63% |
| To-C / file | 1,510 | 3.5% | 0.21 / 1.0 | 5,712 / 22,390 | 523 / 2,045 | 50% | 57% | 86% |
| To-B / api | 150,936 | 87.3% | 21.0 / 34.1 | 589 / 5,764 | 37 / 979 | 0% | 62% | — |
| To-B / text | 21,864 | 12.7% | 3.0 / 5.1 | 479 / 7,695 | 46 / 1,085 | 0% | 60% | — |
到达过程
四条都覆盖约 120 分钟。形状完全不像同一种业务。

- To-B 的 172800 恰好等于 24 × 7200。 像是截了一段平均 24 QPS 的窗口;但 10 秒峰到 37,五分钟均值在 19–30 之间晃,不是均匀合成到达。
- Thinking 开头有尖峰,十分钟后掉到大约 1 QPS。弹性扩缩如果按均值备,会在这段被打穿。
- To-C 在两小时里从 ~3 爬到 ~8。 短窗口也会有趋势,不只是平稳噪声。
到达间隔中位数:To-B 28 ms,To-C / Coder 约 113 ms,Thinking 369 ms。
点开:间隔时间的 CCDF
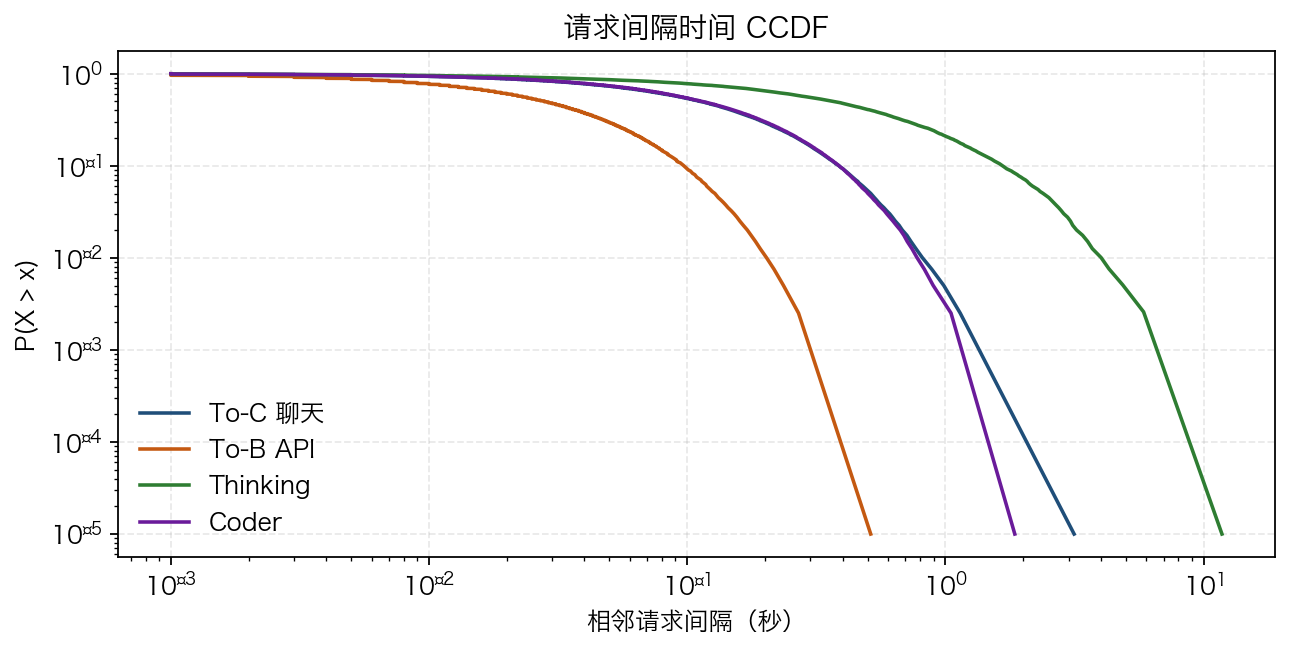
横轴是相邻请求的间隔。越靠右上,越「稀疏」。Thinking 明显更稀,To-B 挤在几十毫秒量级。
To-C 的爬升主要来自 text(约 4.4 QPS)。search 大约稳定在 1 QPS;image / file 更稀。To-B 里 api 约 21 QPS、text 约 3 QPS,两条曲线同涨同落,差在量不在节奏。


Token 形状
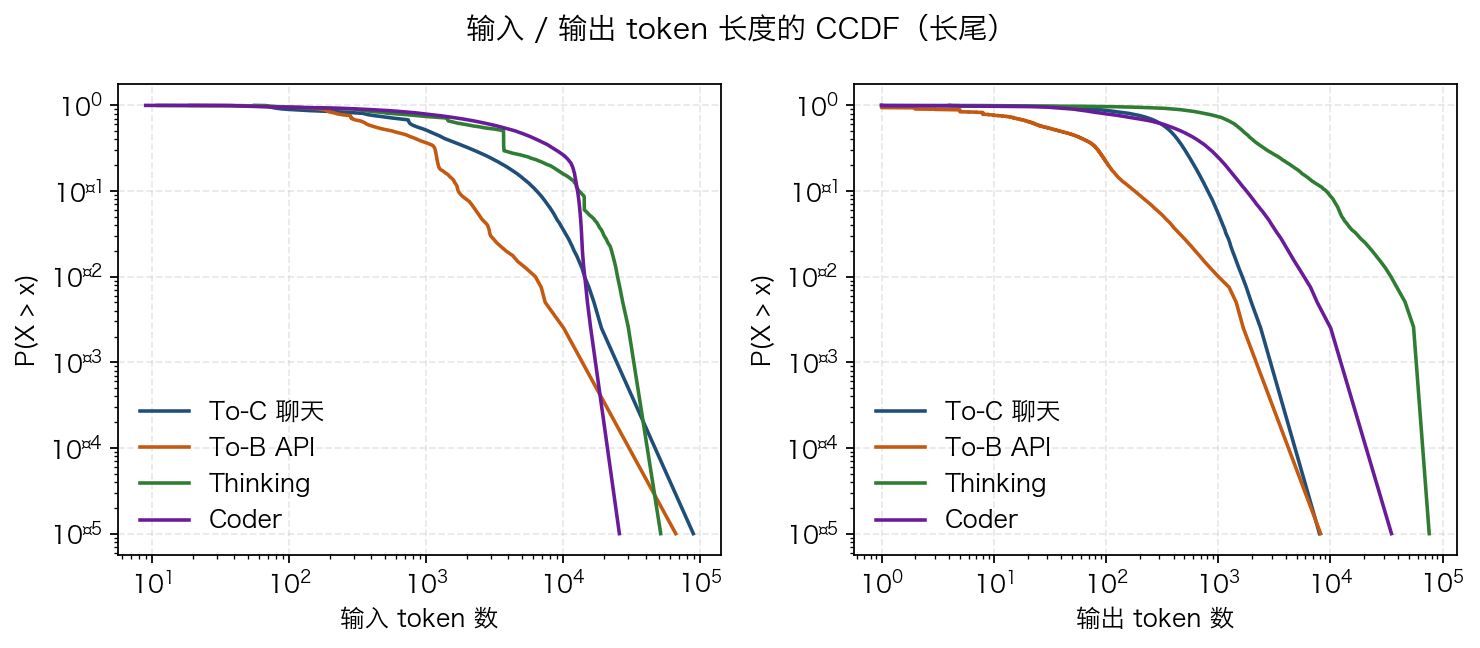
左图输入、右图输出,都是 log-log CCDF。To-B 的输出掉得最快;Thinking 的输出一直拖到 10⁴–10⁵。Coder 输入在 10⁴ 附近有一块平台,很像「仓库/文件上下文被截到某个长度」。

若你关心 GPU 上到底是 prefill 忙还是 decode 忙,看到达 token/s 比看 QPS 更直接:

- Coder:3.4 万 input token/s,四条里 prefill 最重。
- Thinking:输出约 5.5k token/s,几乎赶上它自己的输入。
- To-B:QPS 最高,输出 token/s 反而最低——短答把并发打满,把生成打不满。
点开:输入 vs 输出散点(每条随机 5000 点)

To-B 贴在底部一条「短输出」带上。Thinking 往右上飞。两者几乎没有重叠,硬平均没有意义。
To-C 按 type 再拆,四类几乎是四种业务:
- text:中位输入 790,像普通对话。
- search:中位输入 5.3k,P99 1.7 万。检索拼进 prompt 之后,prefill 比 text 更重——尽管 QPS 只有 text 的四分之一,输入 token/s(6.8k)已经超过 text(5.6k)。
- file:比 search 还长(中位 5.7k,P99 2.2 万),条数最少。
- image:最短。输入中位 369,输出中位 69。更像「看图短答」。

点开:To-C 各 type 的 token CCDF

search / file 的输入长尾明显右移。image 输出掉得最快。
To-B 的 api 与 text 形状很像(输入中位 589 vs 479,输出中位 37 vs 46)。内部再按 type 分,分不出两种 serving 形态。
点开:To-B api vs text 的 token CCDF

两条几乎叠在一起。不要指望用 type=text 把 B 端变成 C 端聊天。

只 replay To-C 的 text,会低估 prefill:search + file 条数不到 23%,输入 token 却占 To-C 的大半。
会话与 KV 缓存
chat_id 在四条里都是 每条请求唯一。会话不是「同一个 chat_id 多行」,而是用 parent_chat_id 连成树。
flowchart LR
  r["根请求 parent = -1"] --> t2["第 2 轮 parent = 根的 chat_id"]
  t2 --> t3["第 3 轮"]
To-B 这棵树退化成 17.3 万个互不连接的点。

- 右图,多轮前缀: 子请求相对父请求,约 67–69% 的 16-token 块能对上。支持「同一会话粘到同一实例」。
- 左图,全局复用: To-B 没有多轮,全局块却仍有 62% 见过。命中来自跨请求的系统提示 / 模板,不是聊天历史。
只为多轮做 session routing,会漏掉 B 端最大的那部分缓存。自动前缀缓存对 API 流量同样重要。Coder 全局复用最高(66%),Thinking 最低(46%)——长推理内容更「一次性」。
点开:会话树规模
| Trace | 会话树数量 | 多轮占比 | 会话大小 P99 | 最大轮次 |
| --- | ---: | ---: | ---: | ---: |
| To-C | 23,101 | 46.3% | 8 | 37 |
| To-B | 172,800 | 0% | 1 | 1 |
| Thinking | 9,612 | 11.1% | 5 | 16 |
| Coder | 26,406 | 38.6% | 9 | 54 |
中位数都是 1:大多数「会话」其实只有一轮。长尾才是 KV 增长的来源。
按 type 看,search / file 相对父请求的前缀命中 86–90%(检索页和文件上下文会在后续轮原样带着);但 search 在 type 内部的全局块复用只有 51%——每次检索内容更「新」。image 相反:多轮只有 8%,全局块复用却高达 85%,像是共享视觉模板。To-B 的 api / text 都是 0% 多轮、约 60% 全局复用,缓存来自模板而不是会话。

前缀缓存:search / file 要靠会话粘性;image / To-B 更靠跨请求模板。Thinking、Coder 没有更细标签,拆不开。
| 系统 | 使用哪条 | 真正打满的是 |
|---|---|---|
| 高并发短 decode、API 网关 | To-B | 调度与 batch 槽位 |
| 前缀缓存、PD 分离、长 prefill | Coder,其次 To-C | KV 容量与 prefill |
| 长 decode、弹性扩缩 | Thinking | max_tokens 与突发 |
| 带搜索/多模态的 C 端 chat | To-C | 中等 prefill + 多轮粘性 |
和 ShareGPT 默认压测的差别:To-B 更短更密;Coder / Thinking 输入长一个数量级;Thinking 输出长一到两个数量级;到达有爬升和尖峰,不是平稳泊松。
点开:和 BurstGPT、Mooncake、Azure 怎么搭配
这份数据 **没有** 天级节律,也 **没有** GPU SM。长周期突发请叠 [BurstGPT](https://github.com/HPMLL/BurstGPT)(213 天)。前缀哈希的另一种块大小(512)见 [Mooncake](https://github.com/kvcache-ai/Mooncake)。对话 vs 代码的一周到达见 [Azure LLM 2024](https://github.com/Azure/AzurePublicDataset/blob/master/AzureLLMInferenceDataset2024.md)。卡侧利用率见阿里 xMaaS / ASI GPU trace,和这份请求日志不是同一层。
块大小不要混:Bailian 是 16,Mooncake 是 512。
replay方法
克隆后 JSONL 走 Git LFS(合计约 300MB):
git lfs install
git clone https://github.com/alibaba-edu/qwen-bailian-usagetraces-anon.git
cd qwen-bailian-usagetraces-anon
git lfs pull
用官方 Trace Replayer(OpenAI 兼容 / TGI / AIBrix):
./client \
  --tokenizer tokenizer.json \
  --endpoint http://localhost:8080/v1/chat/completions \
  --api openai \
  --dataset bailian \
  --dataset-path qwen_traceA_blksz_16.jsonl \
  --scale-factor 1.0 \
  --model-name your-model
或 NVIDIA AIPerf:
aiperf profile \
  --model Qwen/Qwen3-0.6B \
  --endpoint-type chat \
  --streaming \
  --url localhost:8000 \
  --input-file qwen_traceA_blksz_16.jsonl \
  --custom-dataset-type bailian_trace \
  --fixed-schedule
有 timestamp 就用 open-loop / fixed-schedule,不要再套恒定并发。需要打更高 QPS 时用 scale-factor 压时间轴,尽量保留突发形状。
点开:字段坑(官方 FAQ)
多轮里,下一轮输入并不总是完整包含上一轮输出。缺的往往是 chat template 注入的 <think> / </think>,应用层组下一轮上下文时会剥掉。
最后一个块的哈希也可能对不上「输入+第一个输出 token」的朴素拼接:最后一块可能有 padding,第一个生成 token 会改写这块内容,哈希跟着变。这不是丢 token。详见仓库 docs/qa-context-growth-pattern.md。
思考
点开之前先想三秒。
To-B 平均正好 24 QPS,是不是均匀合成的?
不完全是。请求数整除时长,窗口可能经过抽取;但 10 秒峰到 37 QPS,间隔也不是常数。更像「截了两小时、平均 24」而不是恒定间隔生成器。
没有多轮,前缀缓存是不是就没用?
对 To-B 来说,会话前缀没用,**跨请求模板**还有。全局 16-token 块仍有约 62% 复用。
哪条 trace 最像「普通 ChatGPT 聊天」?
只有 To-C。Thinking / Coder 是专用形态;To-B 是 API。四条平均起来什么都不像。
这份数据能告诉我 GPU 利用率吗?
不能。没有 SM、HBM、功耗。只有请求到达和 KV 块。卡侧请另找集群 trace。
- 推不出全天/全周节律(只有 2 小时)。
- 推不出失败率、TTFT、排队。
- 推不出四条在真实线上的流量占比——它们是并列切片,不是 mix 抽样。
- 不能把「平均 token」当成百炼总负载。
参考文献与下载
- 数据:https://github.com/alibaba-edu/qwen-bailian-usagetraces-anon
- Jiahao Wang et al. KVCache Cache in the Wild: Characterizing and Optimizing KVCache Cache at a Large Cloud Provider. USENIX ATC 2025.
- Replay:https://github.com/blitz-serving/trace-replayer
- 许可:Apache 2.0